
guias
Robots.txt para rastreadores de IA: búsqueda, entrenamiento y acceso
¿Cómo permitir la búsqueda con IA sin aceptar todos los rastreadores de entrenamiento?
Leer guía →Base de conocimientos
Guías prácticas sobre rastreo, indexación, alcance por host, sitemaps, parámetros de URL, caché y solución de problemas con robots.txt.
guias
¿Cómo permitir la búsqueda con IA sin aceptar todos los rastreadores de entrenamiento?
Leer guía →
guias
¿Puede robots.txt impedir que una página se indexe y cuándo conviene usar noindex?
Leer guía →
guias
¿Funciona Crawl-delay con Googlebot y cómo se reduce una carga excesiva de rastreo?
Leer guía →
guias
¿Qué regla gana cuando varias reglas Allow y Disallow coinciden con la misma URL?
Leer guía →
guias
¿Qué hace Googlebot cuando robots.txt devuelve 404, 403, 429 o 500?
Leer guía →
guias
¿Dónde añado Sitemap en robots.txt y cómo comprobamos varias referencias?
Leer guía →
guias
¿El robots.txt del dominio principal se aplica a subdominios, HTTP, HTTPS o puertos distintos?
Leer guía →
guias
¿Cómo controlo URLs con parámetros y facetas sin bloquear páginas valiosas?
Leer guía →
guias
¿Qué pasa si robots.txt supera 500 KiB o no está codificado como UTF-8?
Leer guía →
guias
¿Debo usar robots.txt, meta robots, X-Robots-Tag, canonical o autenticación?
Leer guía →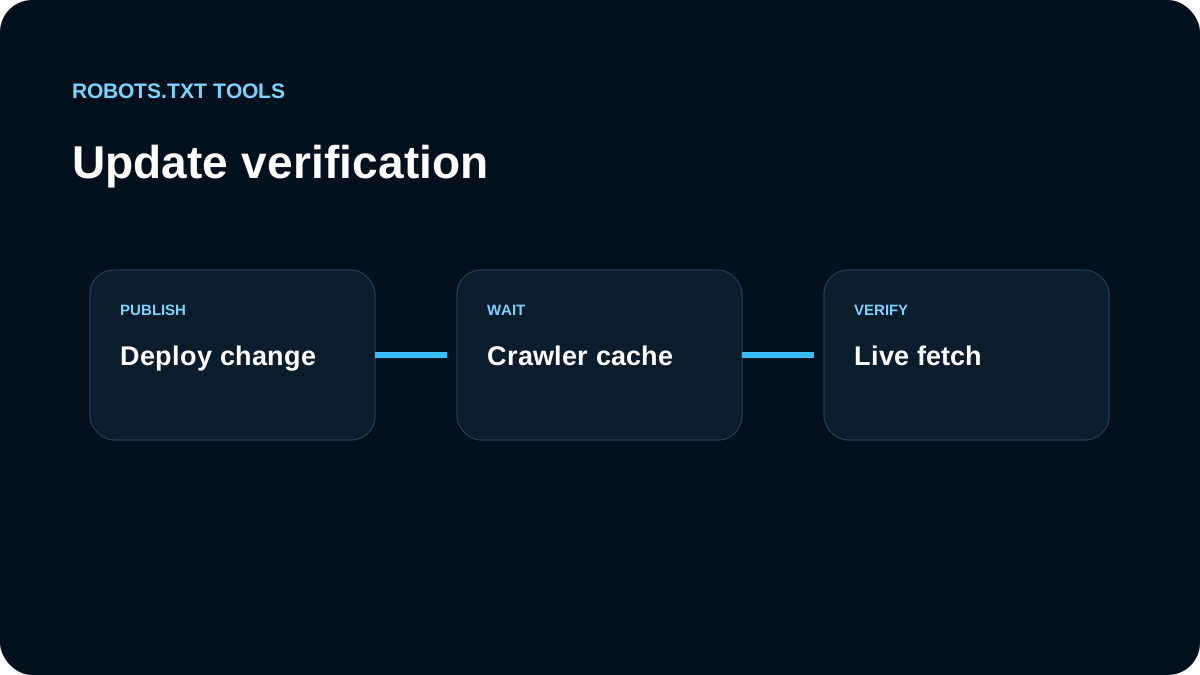
guias
¿Cuánto puede tardar en actualizarse robots.txt y cómo separo caché del crawler de un fallo de despliegue?
Leer guía →
guias
¿Cómo mantengo un staging fuera de Google sin tratar robots.txt como seguridad?
Leer guía →