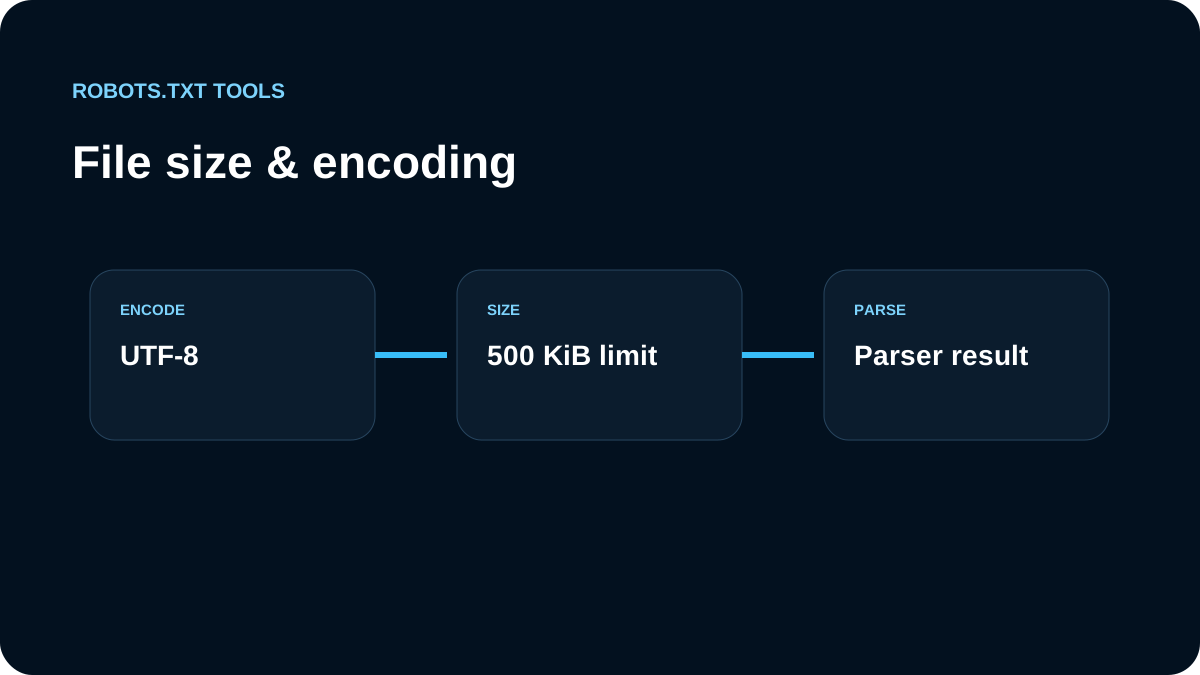
Medimos el archivo que producción entrega, no solo la plantilla. Google documenta un límite de 500 KiB para robots.txt; el contenido posterior al límite puede no procesarse.
Mantenemos UTF-8 predecible
Evitamos codificaciones heredadas y bytes inválidos. Con rutas no ASCII comprobamos tanto el texto como el escape de URL utilizado en las reglas.
Reducimos repetición
Un robots.txt enorme suele contener listas por URL, comentarios generados o grupos duplicados. Preferimos reglas de ruta mantenibles antes que miles de excepciones.
No sacrificamos claridad por tamaño
Reducir líneas no sirve si una wildcard demasiado amplia cambia el comportamiento. Después de cada simplificación usamos el validator y probamos URLs reales.
Comprobamos entrega HTTP
Un archivo pequeño y válido también puede fallar por CDN, redirects o una respuesta distinta en producción. El checker confirma tamaño, estado y contenido público.
Nuestro checklist cubre bytes reales, 500 KiB, UTF-8, grupos, validación, pruebas por crawler y verificación del archivo desplegado.
Qué ocurre al superar 500 KiB
Google mantiene un límite de 500 KiB para robots.txt y puede ignorar el contenido que queda más allá del tamaño procesado. Por eso no buscamos quedarnos justo por debajo del límite: dejamos margen para comentarios, grupos nuevos y cambios de plataforma. Una regla crítica situada después del límite efectivo puede existir en el repositorio y no existir para el crawler.
Los errores de encoding parecen errores de matching
Verificamos la respuesta entregada en UTF-8, no solo cómo se ve en el editor. Revisamos BOM, caracteres de sustitución, rutas no ASCII, diferencias de mayúsculas/minúsculas y formas percent-encoded. También comprobamos que el servidor entregue texto real y no una página HTML de error con estado 200.
Si el archivo crece demasiado, buscamos primero duplicación, reglas generadas por URL y listas masivas de bots. Un patrón estable y comprensible es mejor que miles de excepciones. Después de simplificar, volvemos a validar grupos y a probar URLs reales para confirmar que el comportamiento no cambió.