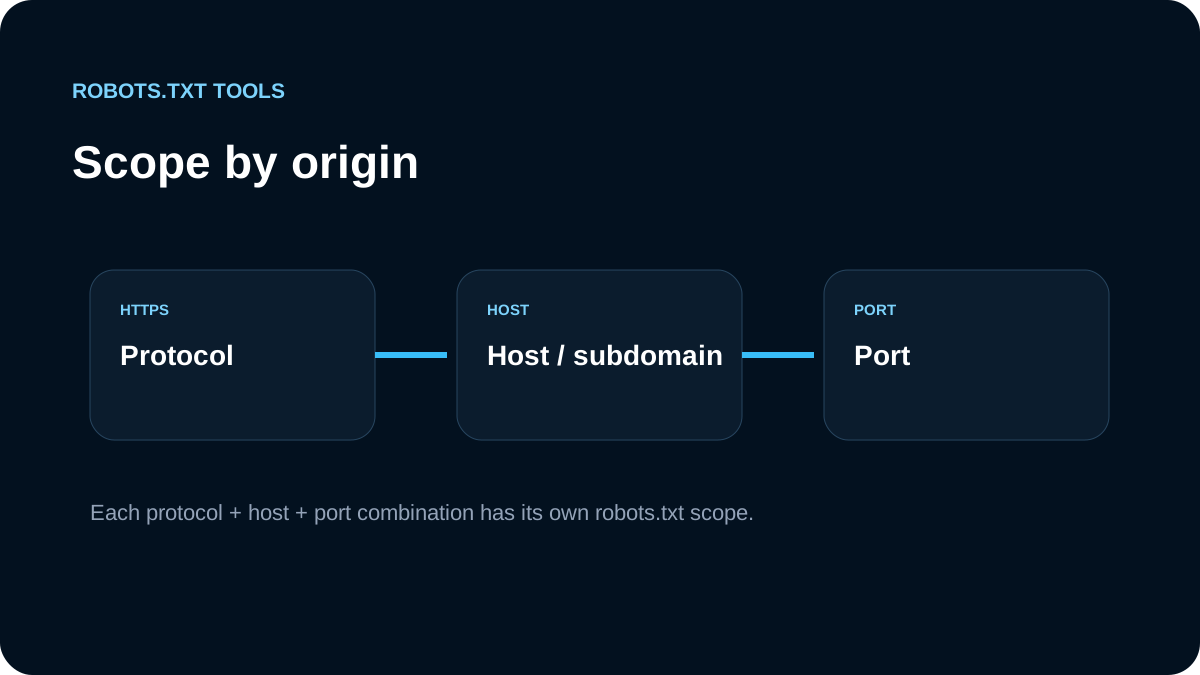
Cuando una regla parece correcta pero no funciona, revisamos el alcance antes que la sintaxis. Robots.txt se aplica al origen: protocolo, host y puerto.
Separamos cada origen
https://example.com/robots.txt
https://www.example.com/robots.txt
https://shop.example.com/robots.txt
http://example.com/robots.txt
https://example.com:8443/robots.txt
No asumimos herencia entre ellos. Un archivo del dominio raíz no controla automáticamente un subdominio.
Hacemos un inventario de hosts
Anotamos producción, www, tienda, documentación, previews y staging. Abrimos /robots.txt en cada host. Esto suele revelar archivos antiguos, 404 o plataformas diferentes.
Identificamos quién sirve el archivo
El apex puede estar en Next.js y la tienda en Shopify. También puede intervenir un CDN o reverse proxy. Antes de editar, confirmamos qué sistema genera la respuesta pública.
Probamos la URL en su propio host
Una URL de shop.example.com se prueba contra la política de ese host. Usamos el tester y revisamos la regla ganadora.
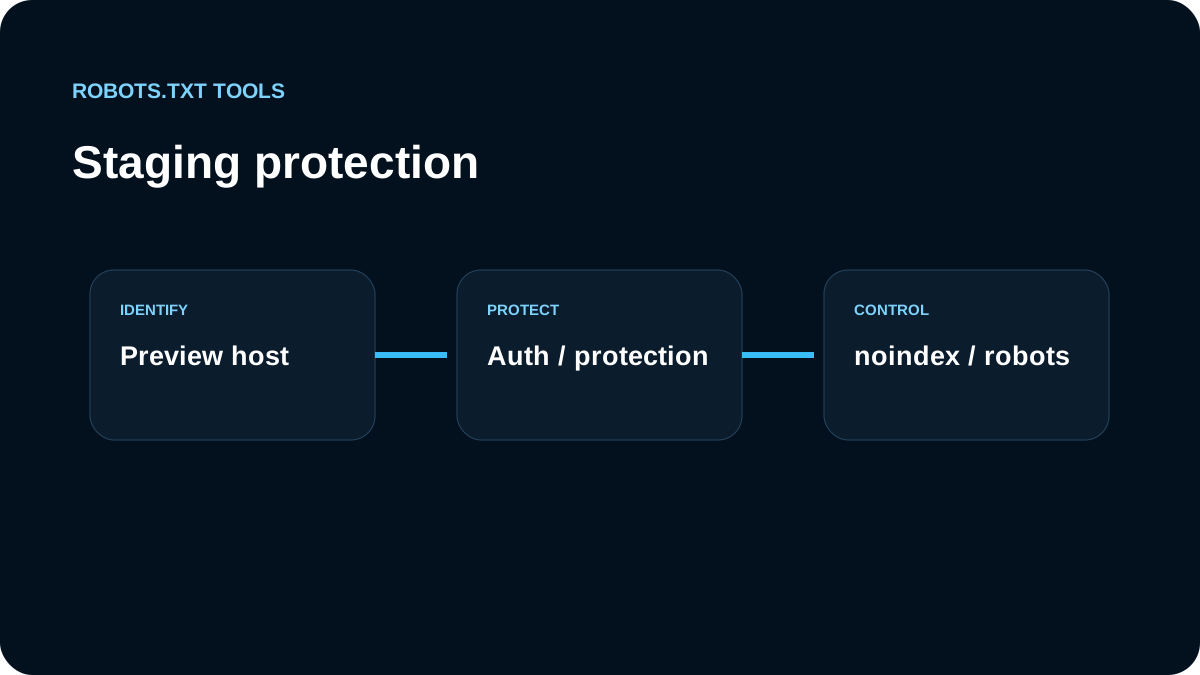
Staging no se protege con Disallow
Para contenido privado usamos autenticación o controles de acceso reales. Disallow: / es una señal de rastreo pública, no seguridad. En previews públicas también revisamos noindex.
Nuestro checklist
Comprobamos protocolo, host, puerto, www, HTTP/HTTPS, propietario del despliegue, staging y respuesta pública con el checker. Pensar por origen evita modificar el robots.txt equivocado.
Matriz de alcance que comprobamos
robots.txt pertenece al origen, no a toda la empresa. Por eso https://example.com/robots.txt controla URLs HTTPS de ese host, pero no hereda automáticamente a shop.example.com, a www.example.com, a HTTP ni a un puerto distinto. En una auditoría anotamos protocolo, host y puerto de cada origen público y abrimos su propio /robots.txt.
Esto es especialmente importante durante migraciones de CDN, cambios entre www y dominio raíz y arquitecturas donde marketing, ecommerce y documentación viven en plataformas distintas. Un archivo correcto en el dominio principal no corrige un subdominio que sigue sirviendo una versión antigua.
Los redirects no fusionan políticas
Que un host redirija al principal no significa que debamos asumir qué robots.txt recibió el crawler. Revisamos la cadena real del recurso /robots.txt, identificamos qué sistema lo sirve —aplicación, CDN, CMS o plataforma— y corregimos la capa propietaria. Así evitamos añadir reglas innecesarias a un archivo que ni siquiera controla el origen problemático.