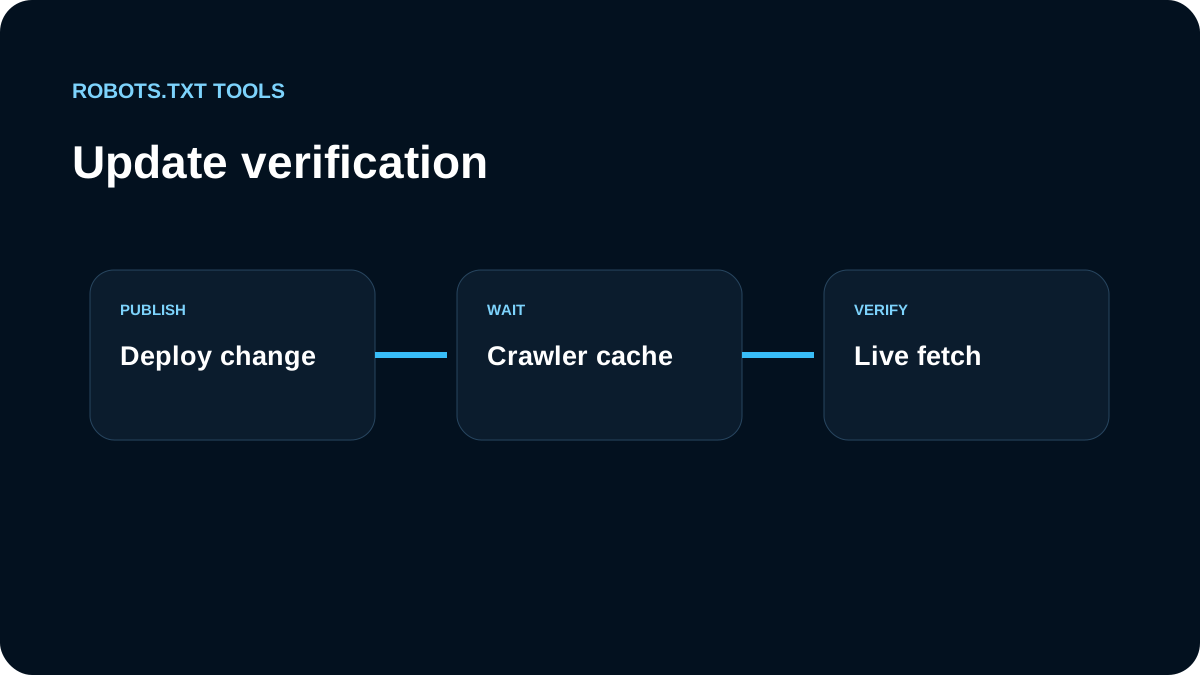
Cuando una modificación parece ignorada, separamos repositorio, respuesta pública y caché del crawler.
Miramos producción primero
Abrimos el origen exacto y comprobamos status HTTP, URL final y cuerpo. Un deploy incompleto o una CDN antigua no es un problema de caché de Google.
Contamos con caché normal
Google documenta que robots.txt suele almacenarse en caché durante aproximadamente 24 horas, aunque el comportamiento puede variar. No republicamos el archivo cada pocos minutos.
Revisamos cada host
www, apex y subdominios pueden tener políticas y cachés distintas. Comprobamos el host que realmente recibe el crawler.
Seguimos la cadena de entrega
Revisamos build, CDN, reverse proxy y generación dinámica. Si aparece un 5xx o 429, cambiamos el diagnóstico antes de tocar reglas.
Verificamos con herramientas
Usamos el checker para la respuesta viva y el tester para URLs concretas. Search Console y logs ayudan a distinguir entrega actual de estado todavía cacheado.
Solo cambiamos reglas de nuevo cuando la versión pública es incorrecta; una demora de caché por sí sola no justifica otra edición.
Usamos la caché documentada como línea base
Google explica que robots.txt suele almacenarse en caché durante unas 24 horas, aunque puede mantenerse más tiempo si la actualización falla por timeout o respuestas 5xx. Las cabeceras de caché también pueden influir. Eso significa que un cambio correcto en producción no siempre modifica el comportamiento del crawler de inmediato.
Nuestro diagnóstico es secuencial: si el checker todavía ve texto viejo, revisamos deploy/CDN; si producción ya sirve el archivo nuevo pero el crawler parece usar reglas antiguas, una caché normal es plausible; si hay errores de servidor, arreglamos disponibilidad antes de interpretar las reglas.
Guardamos evidencia antes y después
Para cambios de riesgo registramos cuerpo anterior, hora de despliegue, status, URL final, headers y cuerpo nuevo. Así distinguimos caché del crawler, caché de CDN y rollback sin publicar otra modificación especulativa. Editar de nuevo mientras el primer cambio aún se propaga solo hace más difícil reconstruir la causa.