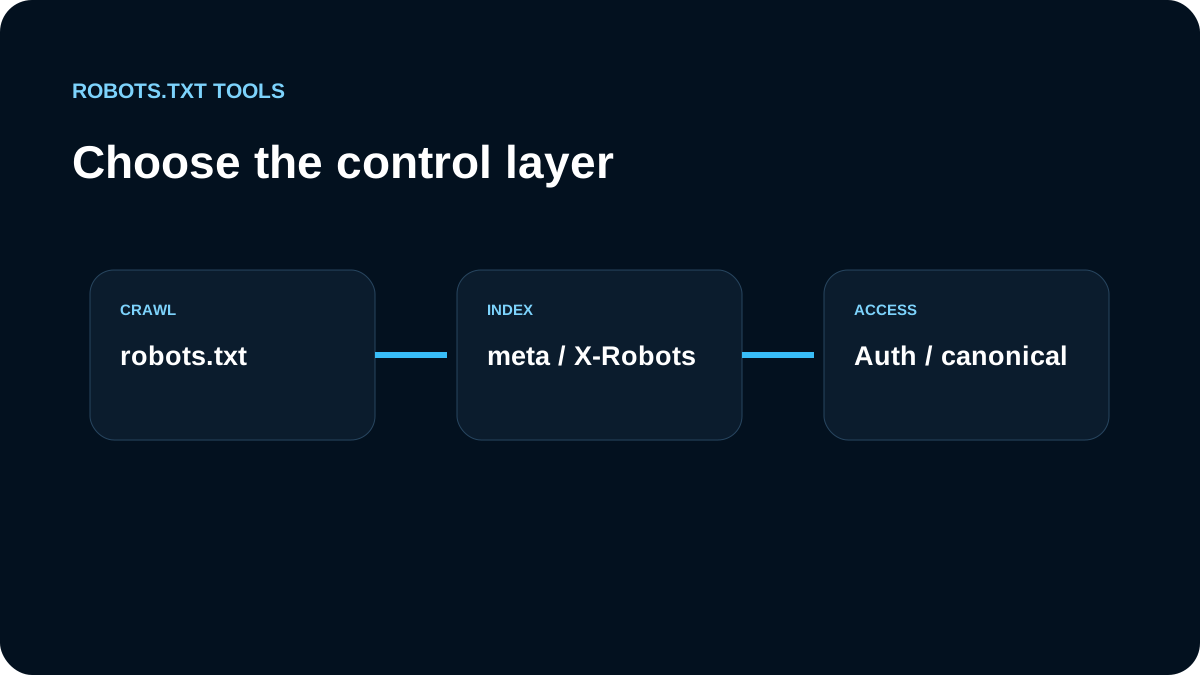
Elegimos la capa según el objetivo. Robots.txt controla rastreo; noindex controla indexación; canonical consolida duplicados; redirects mueven URLs; autenticación protege contenido privado.
Robots.txt responde a una pregunta de rastreo
User-agent: *
Disallow: /internal-search/
No lo tratamos como una orden fiable para eliminar una URL del índice.
Meta robots necesita que el crawler entre
<meta name="robots" content="noindex">
Si robots.txt bloquea la página, el crawler puede no leer ese noindex.
X-Robots-Tag sirve a nivel HTTP
Para PDF u otros recursos podemos usar:
X-Robots-Tag: noindex
La misma condición aplica: el crawler necesita acceso a la respuesta.
Canonical y autenticación tienen funciones distintas
canonical es una señal de consolidación, no privacidad. Para información sensible usamos autenticación o autorización real.
Nuestra secuencia
Privado → autenticación. Público pero fuera de búsqueda → noindex/X-Robots-Tag. Duplicado → canonical o redirect. Desperdicio de crawl → considerar robots.txt. Después verificamos HTML, headers y archivo en producción con el checker.
Combinaciones comunes y su efecto real
Una regla Disallow controla acceso de crawler; noindex pide exclusión de resultados cuando el crawler puede leerla; X-Robots-Tag sirve para PDFs y otros recursos no HTML; canonical consolida duplicados; autenticación protege contenido privado. Mezclar estas capas sin objetivo claro suele crear señales contradictorias.
Por eso no recomendamos “bloquear en robots.txt y añadir noindex por seguridad”. Si el crawler no puede cargar la página, puede no ver el noindex. Para una URL pública que debe desaparecer de resultados, mantenemos el acceso y usamos una directiva de indexación. Para contenido privado, usamos controles de acceso reales.
Diagnosticamos por síntoma
Antes de tocar nada aclaramos si el problema es gasto de rastreo, aparición en resultados, duplicación, migración o privacidad. Elegimos un control principal para ese objetivo y solo añadimos otros si podemos explicar cómo interactúan. Después verificamos robots.txt, HTML o headers y la URL final en producción.