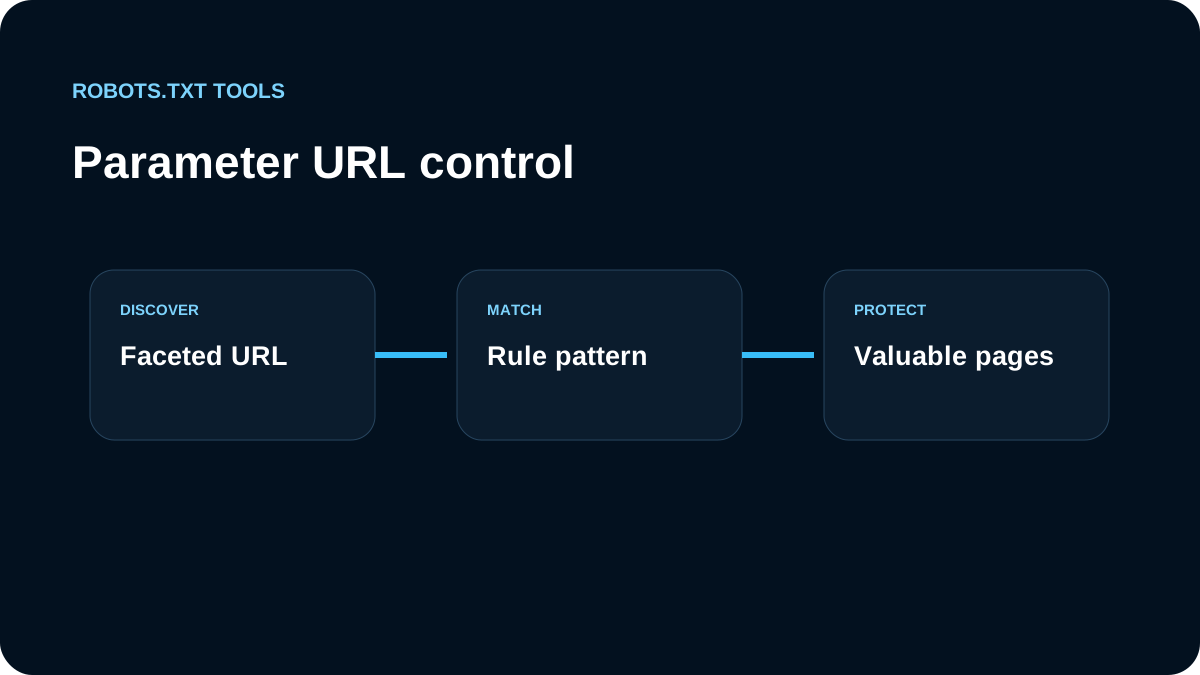
Con URLs como /products?sort=price o /search?q=shoes no empezamos con un Disallow general. Primero clasificamos el parámetro: orden, filtro, faceta, tracking, sesión, paginación o búsqueda interna.
Probamos la query string exacta
User-agent: *
Disallow: /*?sort=
Comprobamos esa regla contra URLs permitidas y bloqueadas con el tester. Un wildcard puede ampliar mucho más de lo esperado.
No usamos robots.txt para todo duplicado
Si ?utm_source= genera el mismo contenido, canonical o una arquitectura de enlaces más limpia puede ser suficiente. Si una URL pública no debe indexarse, evaluamos noindex. Si debe desaparecer porque se movió, evaluamos redirect.
Las facetas necesitan selección
En ecommerce algunas combinaciones pueden tener demanda de búsqueda y otras crear millones de URLs. Evitamos Disallow: /*? salvo que sepamos que ninguna query útil necesita rastreo.
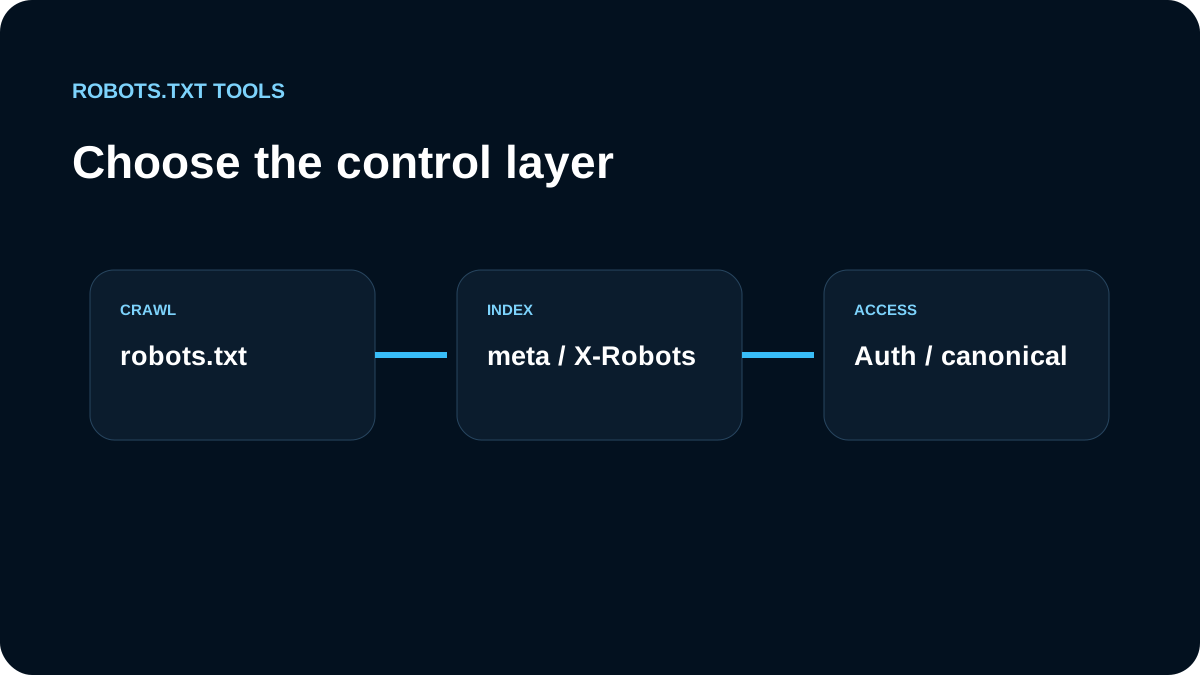
Separamos rastreo e indexación
Robots.txt controla acceso del crawler. noindex controla indexación cuando el crawler puede leerlo. Para comparar capas usamos robots.txt vs meta robots.
Verificamos antes y después
Creamos una matriz de URLs esperadas, validamos la sintaxis y repetimos la prueba sobre el archivo en producción con el checker. Nuestro objetivo es reducir expansión de rastreo sin bloquear páginas con valor real.
Navegación facetada: primero decidimos qué combinaciones tienen valor
La documentación actual de Google trata la navegación facetada como una fuente potencial de espacios de URL casi infinitos. Si esas combinaciones no deben aparecer en búsqueda, puede tener sentido limitar su rastreo; si sí deben ser rastreables, mantenemos un orden de parámetros predecible, evitamos combinaciones duplicadas o absurdas y devolvemos un 404 real cuando una combinación no tiene resultados.
No tratamos igual todos los parámetros. Tracking como utm_source suele resolverse mejor con higiene de enlaces y canonical; búsquedas internas suelen tener poco valor de indexación; ordenaciones pueden ser candidatas a reducción de crawl; facetas de color, talla o categoría necesitan una decisión explícita sobre qué estados merecen landing pages.
Revisamos también quién genera las URLs
robots.txt puede impedir que un crawler compatible solicite un patrón, pero no elimina los enlaces que crean ese espacio. Revisamos navegación, filtros, paginación, JavaScript y sitemaps. Si la aplicación puede dejar de generar combinaciones inútiles, esa solución suele ser más mantenible que ampliar robots.txt indefinidamente.