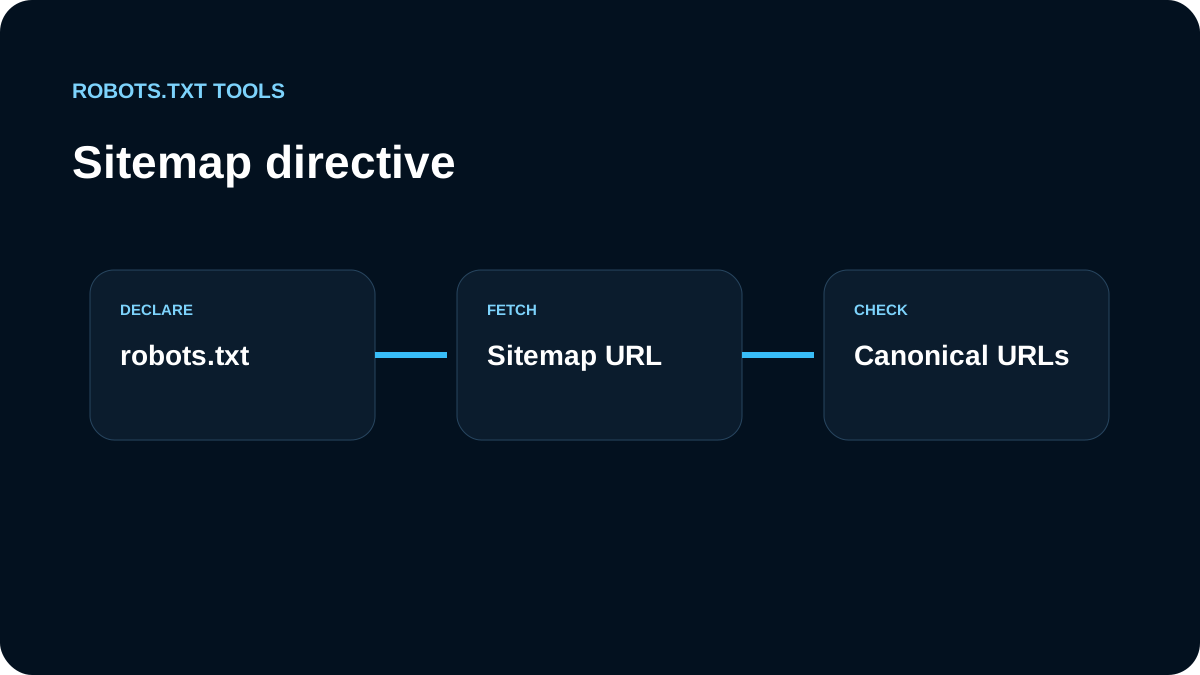
Cuando revisamos un robots.txt, tratamos Sitemap: como una referencia de descubrimiento, no como una regla Allow o Disallow.
Verificamos primero el sitemap
Abrimos el XML y comprobamos estado HTTP, host canónico, HTTPS y URLs indexables. Después usamos una URL absoluta:
Sitemap: https://example.com/sitemap.xml
No usamos Sitemap: /sitemap.xml.
Un índice suele ser más mantenible
Si el sitio tiene varios sitemaps, podemos declarar varias líneas, pero cuando existe un índice estable preferimos referenciarlo. Así robots.txt no se convierte en una segunda lista que hay que mantener.
Sitemap: https://example.com/sitemap-index.xml
Revisamos host y subdominios
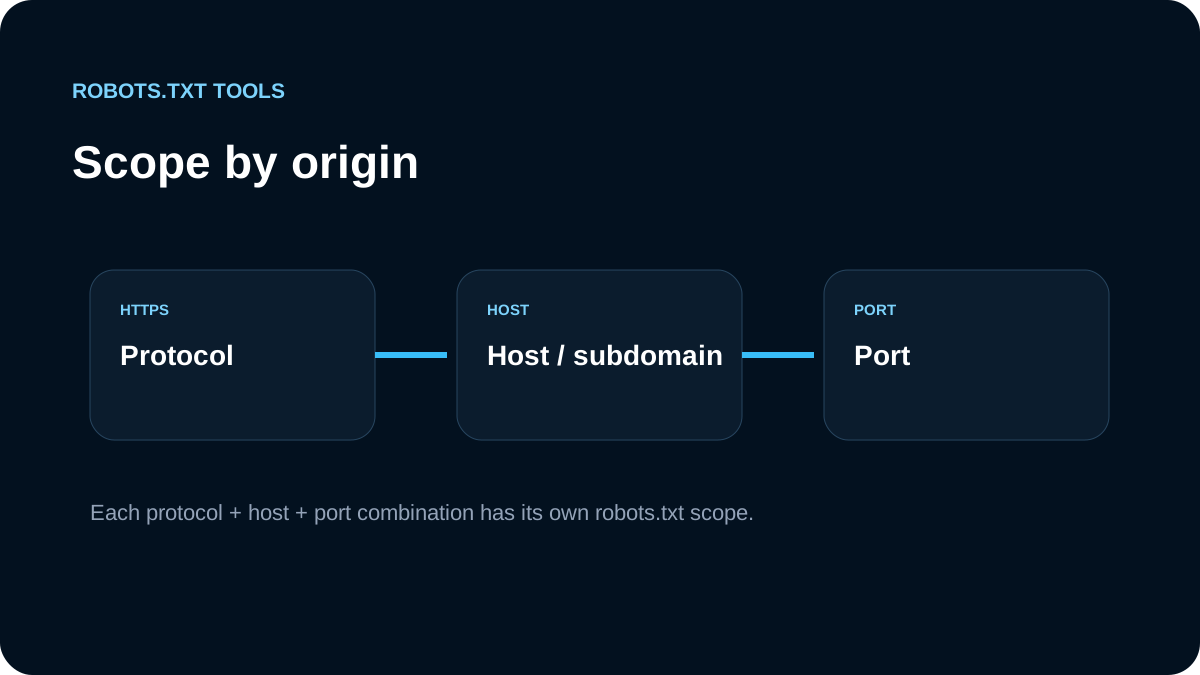
https://example.com/robots.txt y https://shop.example.com/robots.txt tienen ámbitos distintos. En arquitecturas con varios hosts comprobamos cada origen y no asumimos que una declaración se hereda. Para ese caso usamos la guía de subdominios.
Search Console sigue siendo útil
La línea Sitemap facilita el descubrimiento, pero no sustituye el seguimiento en Search Console. Un sitemap puede estar bien enlazado y aun contener redirecciones, URLs noindex o versiones no canónicas.
Comprobamos producción
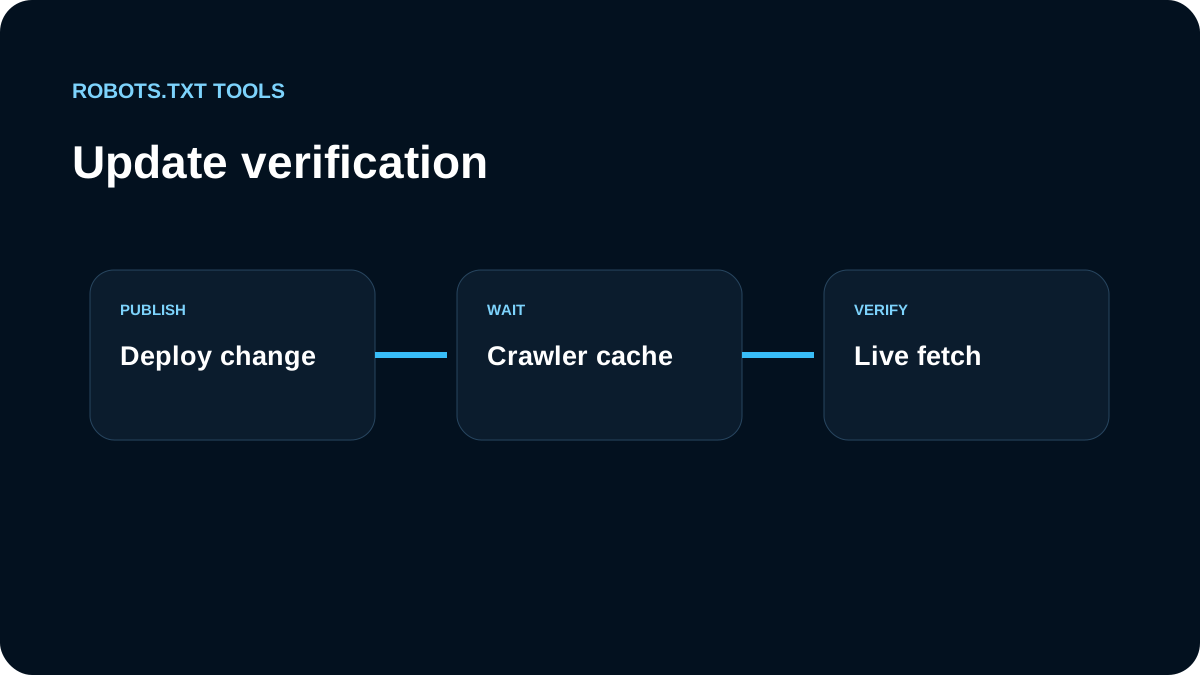
Nuestro flujo final es abrir /robots.txt, abrir cada sitemap, revisar una muestra de URLs y pasar el archivo por el checker y el validator. Si también cambiamos reglas de rastreo, usamos el tester.
La regla práctica es sencilla: una referencia estable, absoluta y canónica, verificada en la respuesta pública real.
Qué puede y qué no puede hacer la línea Sitemap
Sitemap: ayuda a descubrir XML, pero no vuelve indexables las URLs ni anula reglas Disallow. Usamos siempre una URL absoluta con protocolo y host, y comprobamos que el XML pertenezca al entorno de producción. Si existe un índice estable, preferimos enlazarlo en lugar de repetir todos los sitemaps secundarios en robots.txt.
También aceptamos sitemaps alojados en otro host cuando la arquitectura lo requiere, pero verificamos quién los genera y qué propiedad representan. Un sitemap de CDN o de una migración antigua puede ser técnicamente válido y aun así anunciar URLs equivocadas. En migraciones, revisamos a la vez redirecciones, canonical, sitemap y Search Console para que todos indiquen el mismo host.
Comprobaciones que hacemos antes de publicar
Confirmamos URL absoluta, host de producción, estado HTTP, ausencia de URLs noindex o redirigidas y una muestra de URLs canónicas. La línea en robots.txt es solo una ruta de descubrimiento; la calidad del XML sigue siendo la parte importante.