
guides
Robots.txt pour les crawlers IA : recherche, entraînement et accès
Comment autoriser la recherche avec IA sans ouvrir tous les crawlers d’entraînement ?
Lire le guide →Base de connaissances
Guides pratiques sur l’exploration, l’indexation, la portée par hôte, les sitemaps, les paramètres d’URL, le cache et le dépannage de robots.txt.
guides
Comment autoriser la recherche avec IA sans ouvrir tous les crawlers d’entraînement ?
Lire le guide →
guides
robots.txt peut-il empêcher l’indexation et quand faut-il utiliser noindex ?
Lire le guide →
guides
Crawl-delay fonctionne-t-il avec Googlebot et comment réduire une charge d’exploration excessive ?
Lire le guide →
guides
Quelle règle l’emporte lorsque plusieurs Allow et Disallow correspondent à la même URL ?
Lire le guide →
guides
Comment Googlebot traite-t-il un robots.txt en 404, 403, 429 ou 500 ?
Lire le guide →
guides
Où ajouter Sitemap dans robots.txt et comment vérifier plusieurs références ?
Lire le guide →
guides
Le robots.txt du domaine principal s’applique-t-il aux sous-domaines, HTTP, HTTPS ou autres ports ?
Lire le guide →
guides
Comment contrôler les URL à paramètres et facettes sans bloquer des pages utiles ?
Lire le guide →
guides
Que se passe-t-il si robots.txt dépasse 500 KiB ou n’est pas en UTF-8 ?
Lire le guide →
guides
Faut-il utiliser robots.txt, meta robots, X-Robots-Tag, canonical ou authentification ?
Lire le guide →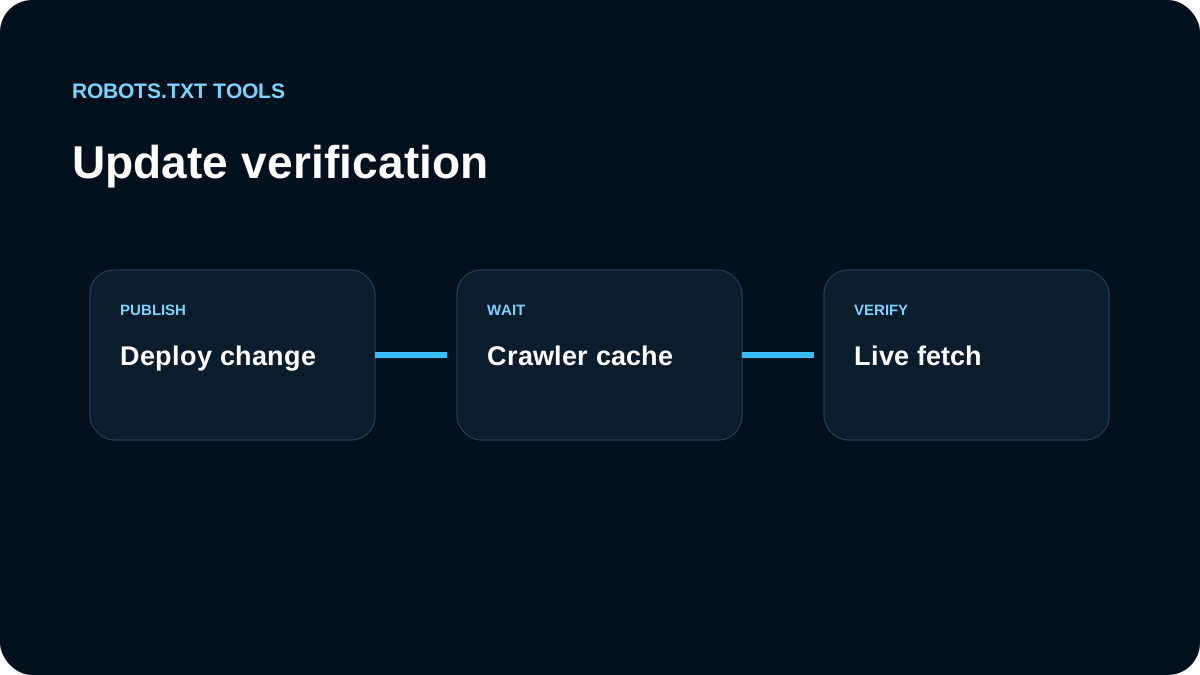
guides
Combien de temps robots.txt reste-t-il en cache et comment distinguer cache du crawler et erreur de déploiement ?
Lire le guide →
guides
Comment garder une préproduction hors de Google sans utiliser robots.txt comme sécurité ?
Lire le guide →