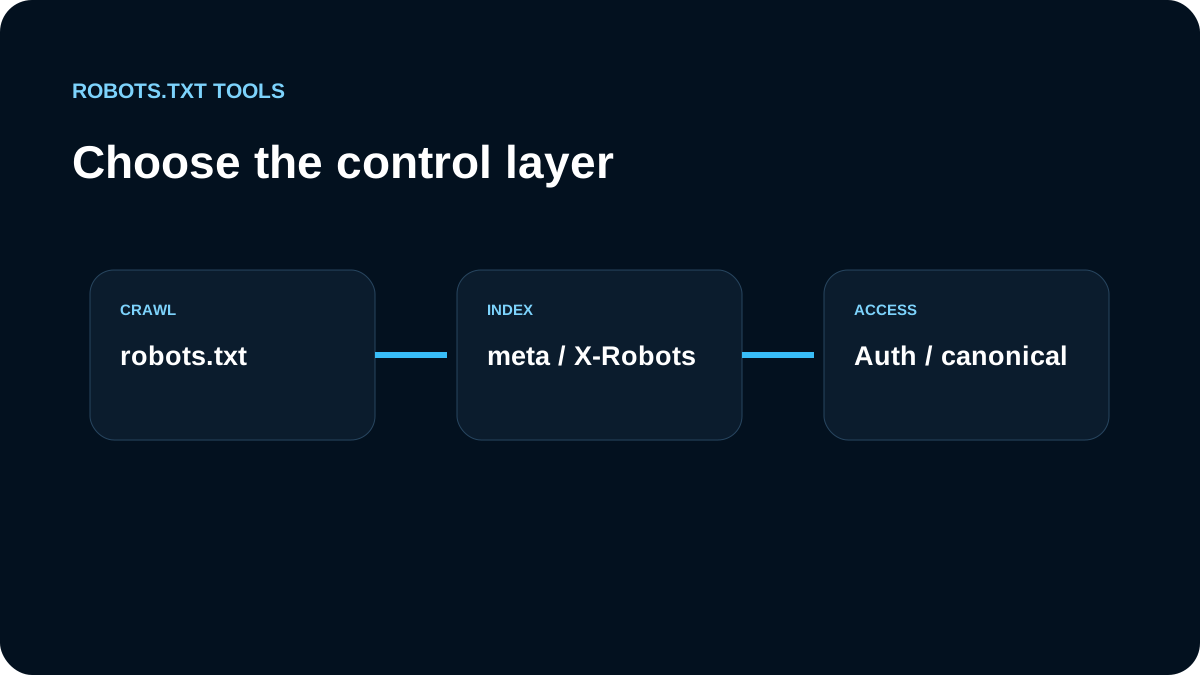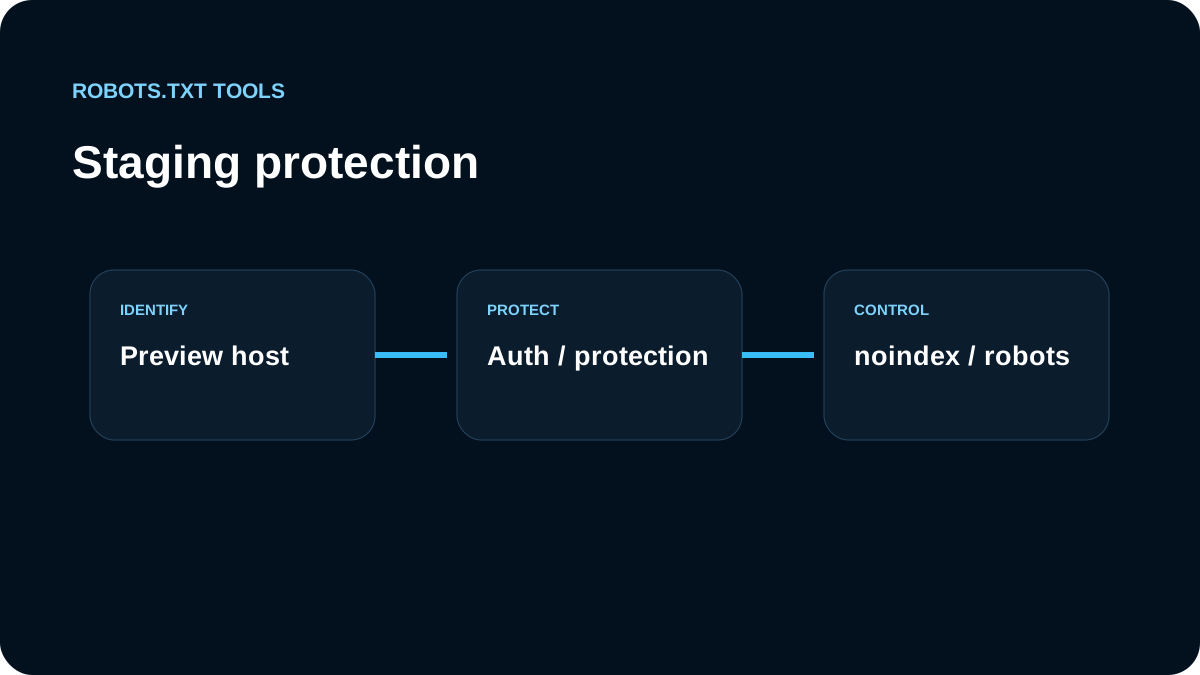
Pour la préproduction, notre première couche est l’accès et non robots.txt.
Nous protégeons le privé par authentification
Mot de passe, authentification ou restriction réseau protègent réellement l’environnement. Disallow: / n’est pas de la sécurité.
Un preview public peut nécessiter noindex
Si une URL doit rester accessible pour validation mais hors recherche, nous utilisons noindex tout en laissant le crawler lire la directive.
Robots.txt reste secondaire
User-agent: *
Disallow: /
Cela peut réduire le crawl sans remplacer contrôle d’accès ou noindex.
Nous séparons préproduction et production
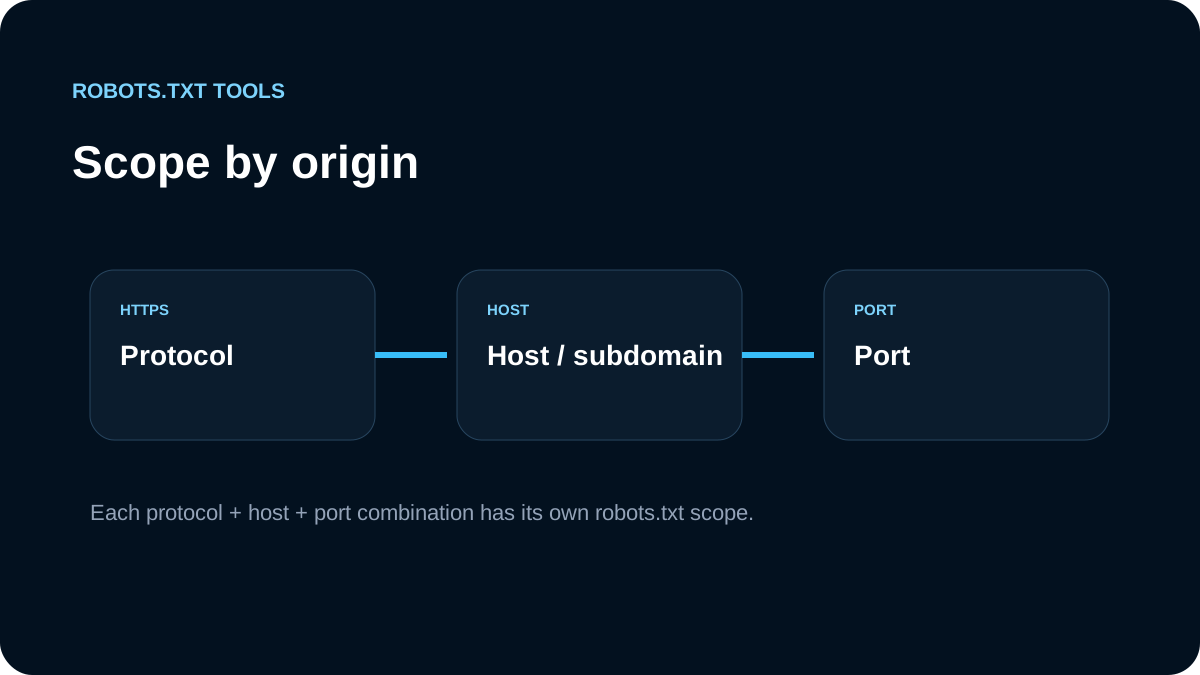
Nous vérifions les deux hosts, supprimons les sitemaps de test et empêchons Disallow: / d’être promu en production.
Notre gate de release
Nous testons les URL de production avec le tester et le fichier live avec le checker.
Le bon contrôle dépend de l’exposition
Une préproduction interne ou réservée à un client doit utiliser authentification ou restriction réseau. Une preview publique qui doit rester accessible mais absente des résultats peut utiliser noindex tout en restant crawlable. robots.txt reste une couche secondaire de crawl, pas une frontière de sécurité.
Le risque le plus grave est qu’un Disallow: / de préproduction arrive en production. Nous traitons donc la politique de production comme un gate explicite du release.
Nous retirons aussi les anciennes previews
Après lancement, nous supprimons l’accès public aux previews inutiles ou gardons leur authentification. Si un host de staging est déjà indexé, ajouter seulement Disallow: / n’est pas une procédure de retrait. Nous choisissons entre accès protégé, statut HTTP approprié ou période crawlable avec noindex selon le cas.
Contrôle de release contre les fuites de configuration
Avant la mise en production, nous vérifions aussi liens internes, sitemap, canonical et variables d’environnement pour repérer toute référence au host de préproduction. Après le déploiement, nous ouvrons plusieurs pages publiques et comparons leurs directives d’indexation avec le robots.txt final. Cela permet de détecter autre chose qu’un simple Disallow: / oublié.