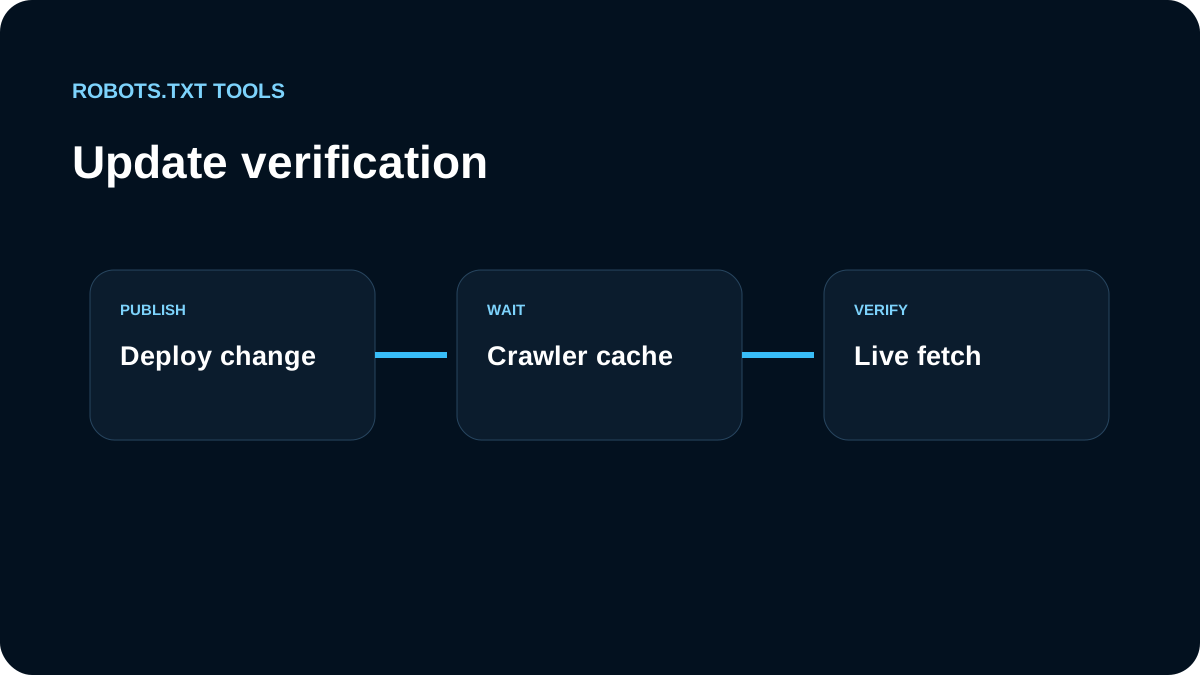
Quand une modification semble ignorée, nous séparons dépôt, réponse publique et cache du crawler.
Nous contrôlons d’abord la production
Nous récupérons le host exact et notons statut, URL finale et corps. Un ancien objet CDN ou un mauvais déploiement n’est pas un cache Google.
Nous tenons compte du cache normal
Google documente généralement une mise en cache d’environ 24 heures, avec des variations possibles.
Nous vérifions chaque origine
Apex, www et sous-domaines peuvent servir des versions différentes. Nous retraçons aussi build, CDN, reverse proxy et génération dynamique.
Un statut d’erreur change le diagnostic
Un 5xx ou 429 n’a pas la même signification qu’un 200 avec ancien contenu.
Nous vérifions le fichier live
Le checker montre la version publique, le tester vérifie des URL précises. Search Console et logs complètent le diagnostic.
La fenêtre de cache sert de référence
Google indique que robots.txt est généralement mis en cache environ 24 heures, plus longtemps si le rafraîchissement échoue à cause de timeouts ou de réponses 5xx. Les headers de cache peuvent également influencer la durée. Un fichier correct en production ne signifie donc pas un changement immédiat du comportement du crawler.
Si le checker voit encore l’ancien texte, nous examinons déploiement et CDN. Si la réponse publique est nouvelle mais le comportement ancien, le cache du crawler devient plausible. En cas d’erreur serveur, nous corrigeons d’abord la disponibilité.
Nous conservons un avant/après
Pour les changements sensibles, nous enregistrons ancien body, heure de déploiement, statut, URL finale, headers et nouveau body. Cela permet de distinguer cache crawler, cache edge et rollback sans republier une modification spéculative.