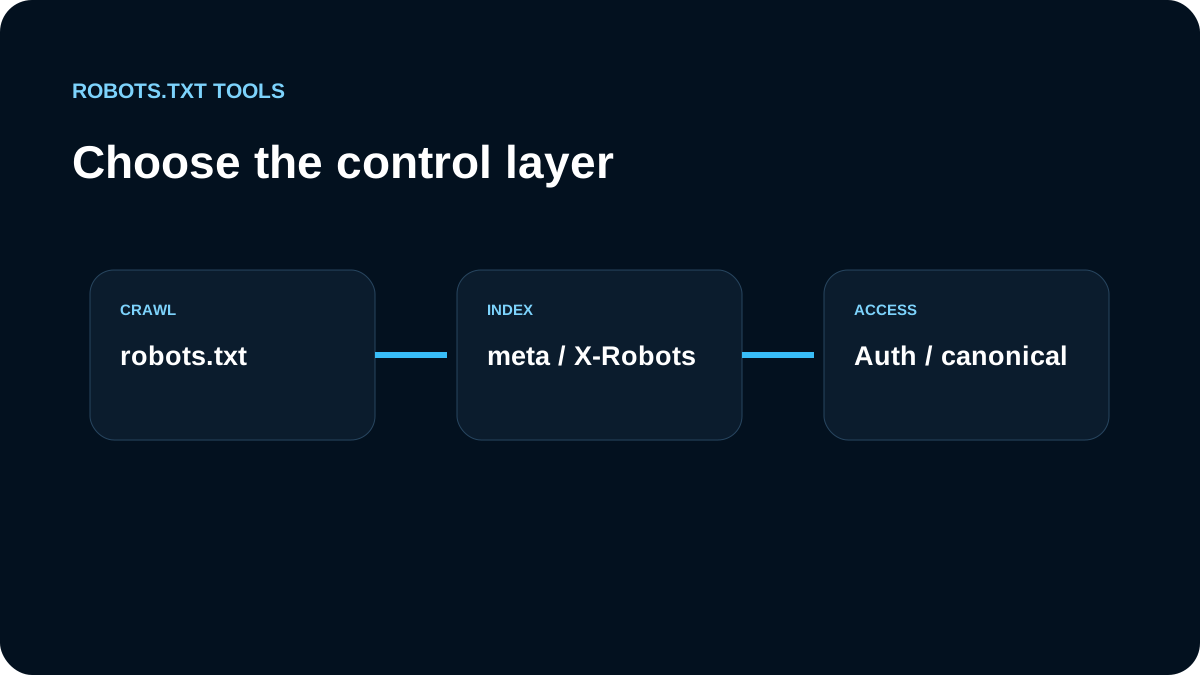
Nous choisissons la couche selon l’objectif : robots.txt pour le crawl, noindex pour l’indexation, canonical pour les doublons, redirection pour un déplacement, authentification pour le privé.
Robots.txt répond à une question de crawl
Disallow n’est pas une commande fiable de suppression d’index.
Meta robots doit être lisible
<meta name="robots" content="noindex">
Si robots.txt bloque la page, le crawler peut ne pas lire noindex.
X-Robots-Tag agit dans la réponse HTTP
X-Robots-Tag: noindex
Cette solution convient notamment aux PDF et ressources non HTML.
Canonical ne protège pas un contenu privé
canonical consolide des signaux. Nous utilisons authentification ou autorisation pour la confidentialité.
Notre séquence de décision
Privé → authentification. Public hors index → noindex/X-Robots-Tag. Doublon → canonical ou redirection. Crawl inutile → évaluer robots.txt. Enfin nous vérifions la production avec le checker.
Chaque contrôle répond à un problème différent
Disallow gère l’exploration ; noindex demande l’exclusion des résultats quand le crawler peut lire la page ; X-Robots-Tag convient aux PDF et autres ressources non HTML ; canonical consolide les doublons ; l’authentification protège le privé. Nous ne les traitons pas comme des couches interchangeables.
Bloquer une page dans robots.txt puis ajouter noindex peut être contradictoire : le crawler risque de ne jamais lire la directive d’indexation. Pour une URL publique à retirer des résultats, nous laissons l’accès et utilisons noindex. Pour des données confidentielles, nous utilisons un vrai contrôle d’accès.
Nous partons du symptôme
Le besoin est-il de réduire le crawl, retirer une URL, consolider un doublon, migrer ou protéger un contenu ? Nous choisissons ensuite un contrôle principal, puis vérifions robots.txt, HTML/headers et la réponse finale en production.