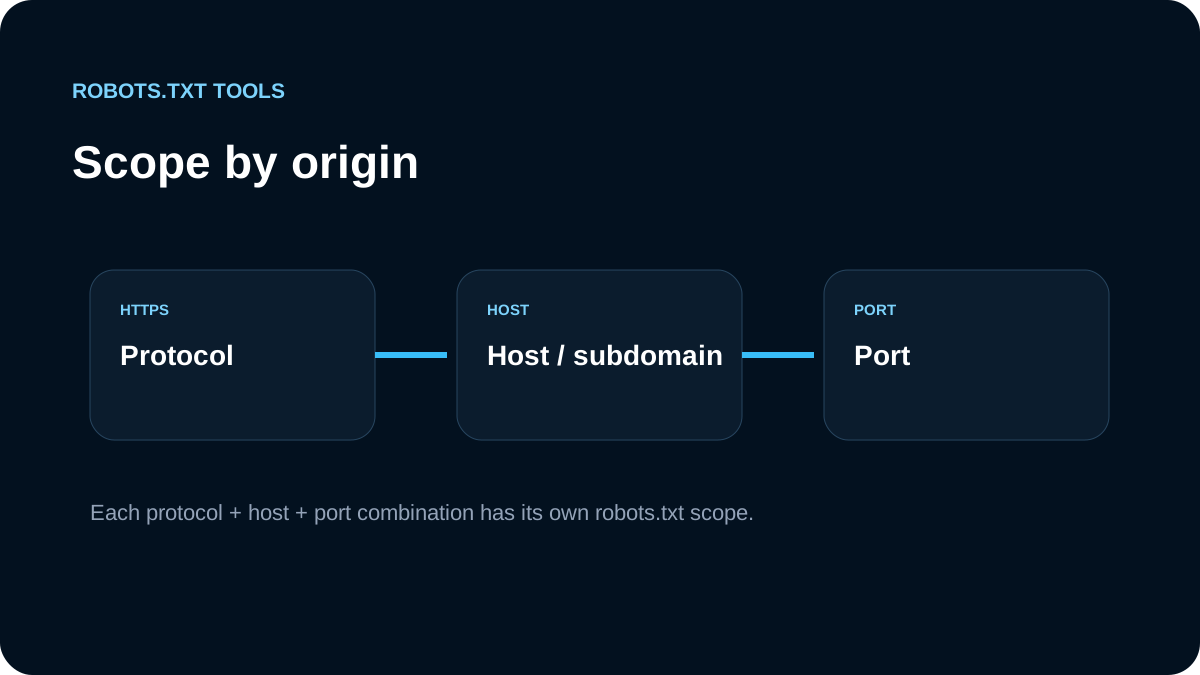
Lorsqu’une règle semble correcte sans effet, nous vérifions la portée avant la syntaxe. Robots.txt est lié à une origine : protocole, host et port.
Nous séparons chaque origine
https://example.com/robots.txt
https://shop.example.com/robots.txt
http://example.com/robots.txt
https://example.com:8443/robots.txt
Aucune héritage automatique ne relie ces fichiers.
Nous dressons la liste des hosts
Production, www, boutique, documentation, preview et préproduction sont contrôlés séparément. Cela révèle souvent un fichier obsolète ou une autre plateforme.
Nous identifions la couche qui publie
Framework, CMS, CDN ou reverse proxy peuvent posséder la réponse publique. Nous modifions la couche qui sert réellement /robots.txt.
Nous testons sur le bon host
Une URL de boutique est testée avec la politique de cette boutique. Le tester montre la règle gagnante et le checker confirme le fichier public.
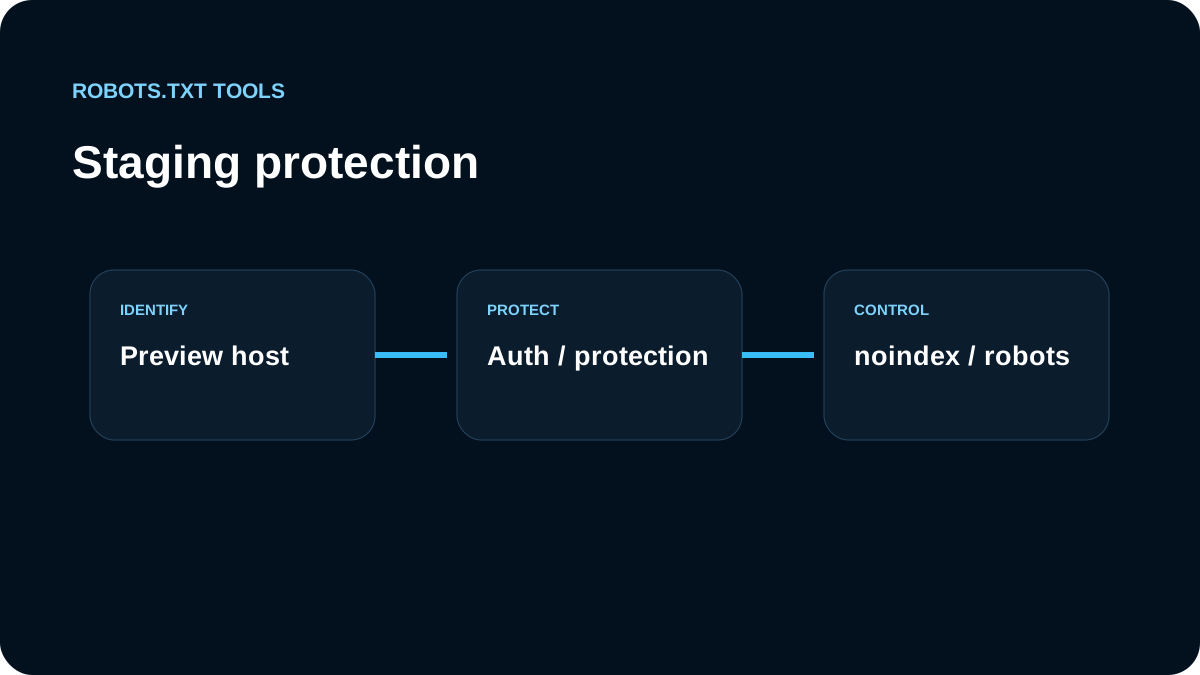
La sécurité de préproduction est séparée
Pour du contenu privé, nous utilisons authentification ou contrôle d’accès. Disallow: / n’est pas une mesure de sécurité. Pour un preview public, nous vérifions aussi noindex.
Le périmètre est celui de l’origine
robots.txt appartient au couple protocole + hôte + port. Le fichier de https://example.com ne contrôle pas automatiquement shop.example.com, www.example.com, HTTP ou un autre port. Nous listons donc toutes les origines publiques et récupérons leur propre /robots.txt.
Cette méthode évite de corriger le domaine principal alors qu’un sous-domaine continue de servir une version ancienne via un autre CMS, CDN ou service.
Les redirections ne fusionnent pas les politiques
Même si www redirige vers le domaine racine, nous inspectons la chaîne réelle de /robots.txt. Nous identifions la couche qui possède la réponse — application, CDN, CMS ou plateforme — puis modifions celle-ci. Cela évite d’ajouter des règles dans un fichier qui ne contrôle pas l’origine problématique.