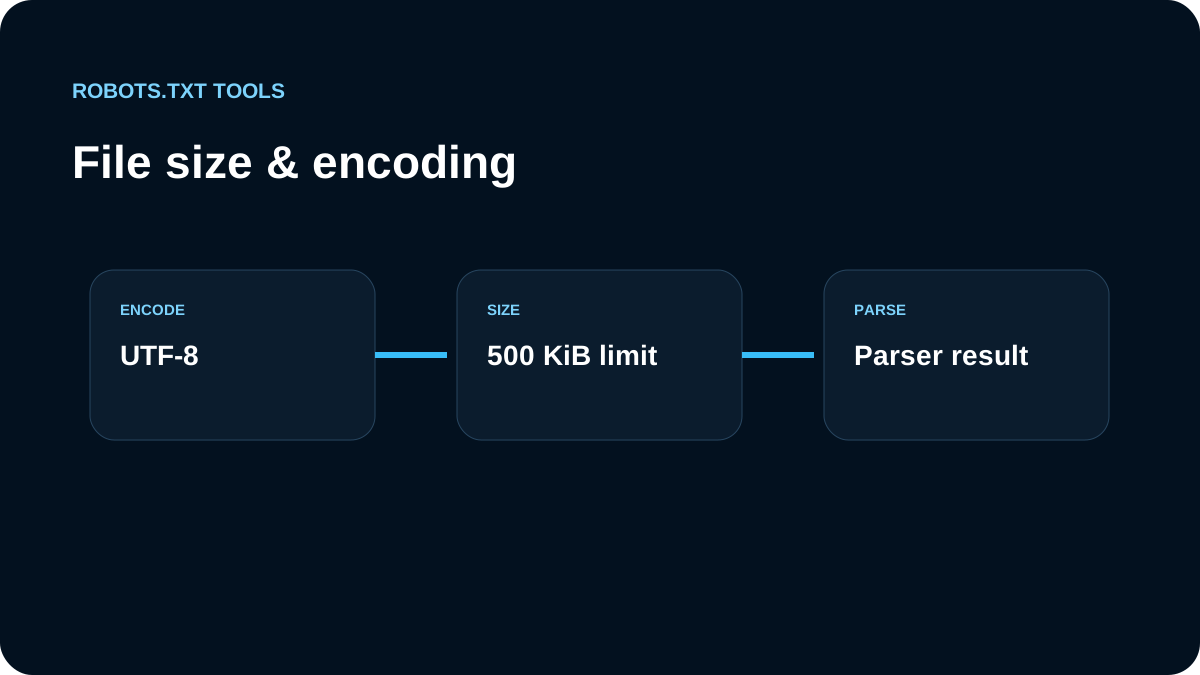
Nous mesurons le fichier servi en production. Google documente une limite de 500 KiB ; le contenu au-delà peut être ignoré.
Nous gardons un UTF-8 prévisible
Nous évitons les encodages historiques et les octets invalides. Pour les chemins non ASCII, nous contrôlons aussi l’échappement d’URL.
Nous réduisons la répétition
Les gros fichiers contiennent souvent des URL listées une par une, des commentaires générés ou des groupes dupliqués. Des règles de chemin stables restent plus faciles à maintenir.
Nous validons après simplification
Une wildcard raccourcie peut devenir trop large. Nous utilisons le validator puis testons des URL réelles.
Nous contrôlons la livraison HTTP
CDN, redirection ou génération dynamique peuvent servir autre chose que le fichier source. Le checker confirme statut, contenu et version de production.
La limite de 500 Kio a un effet réel
Google traite robots.txt jusqu’à environ 500 Kio et peut ignorer ce qui se trouve au-delà. Nous gardons donc une marge importante. Une règle critique placée après la limite peut exister dans le dépôt tout en étant invisible pour le crawler.
Les erreurs d’encodage peuvent ressembler à des erreurs de matching
Nous vérifions les octets UTF-8 servis, pas seulement l’affichage dans l’éditeur : BOM, caractères de remplacement, chemins non ASCII, casse et formes percent-encoded. Nous confirmons aussi que le serveur renvoie du texte, pas une page d’erreur HTML masquée.
Quand le fichier grossit, nous cherchons d’abord les groupes répétés, règles par URL et listes de bots trop longues. Un ensemble de règles plus petit et explicable est plus sûr qu’une collection d’exceptions impossible à auditer.