
ratgeber
Robots.txt für KI-Crawler: Suche, Training und Bot-Zugriff trennen
Wie lässt sich KI-Suche erlauben, ohne jeden Trainings-Crawler freizugeben?
Anleitung lesen →Wissensdatenbank
Praxisnahe Anleitungen zu Crawling, Indexierung, Host-Gültigkeitsbereich, Sitemaps, URL-Parametern, Cache und robots.txt-Fehlersuche.
ratgeber
Wie lässt sich KI-Suche erlauben, ohne jeden Trainings-Crawler freizugeben?
Anleitung lesen →
ratgeber
Kann robots.txt eine Indexierung verhindern und wann ist noindex die richtige Wahl?
Anleitung lesen →
ratgeber
Funktioniert Crawl-delay bei Googlebot und wie lässt sich zu hohe Crawl-Last beheben?
Anleitung lesen →
ratgeber
Welche Regel gewinnt, wenn mehrere Allow- und Disallow-Regeln auf dieselbe URL passen?
Anleitung lesen →
ratgeber
Wie behandelt Googlebot 404, 403, 429 oder 500 bei robots.txt?
Anleitung lesen →
ratgeber
Wo trage ich Sitemap in robots.txt ein und wie prüfe ich mehrere Referenzen?
Anleitung lesen →
ratgeber
Gilt robots.txt der Hauptdomain für Subdomains, HTTP, HTTPS oder andere Ports?
Anleitung lesen →
ratgeber
Wie kontrolliere ich Parameter- und Facetten-URLs, ohne wichtige Seiten zu blockieren?
Anleitung lesen →
ratgeber
Was passiert, wenn robots.txt größer als 500 KiB oder nicht UTF-8 ist?
Anleitung lesen →
ratgeber
Soll ich robots.txt, Meta Robots, X-Robots-Tag, Canonical oder Authentifizierung verwenden?
Anleitung lesen →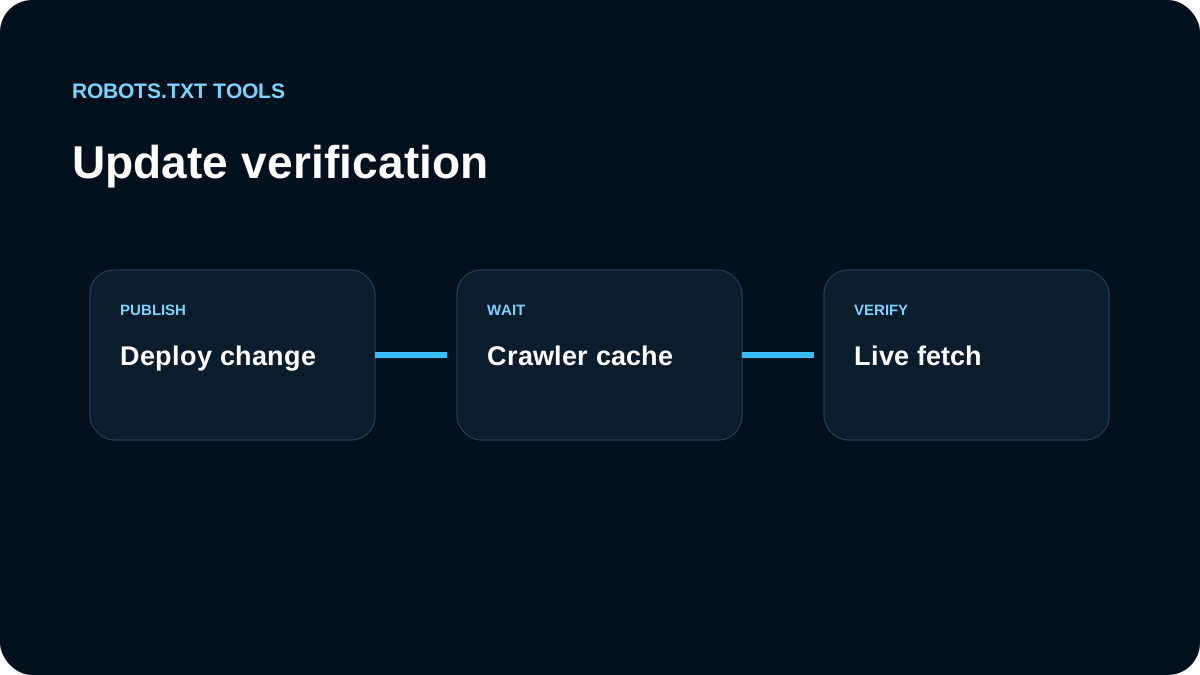
ratgeber
Wie lange bleibt robots.txt im Cache und wie unterscheide ich Crawler-Cache von einem Deployment-Fehler?
Anleitung lesen →
ratgeber
Wie halte ich Staging aus der Suche, ohne robots.txt als Security zu behandeln?
Anleitung lesen →