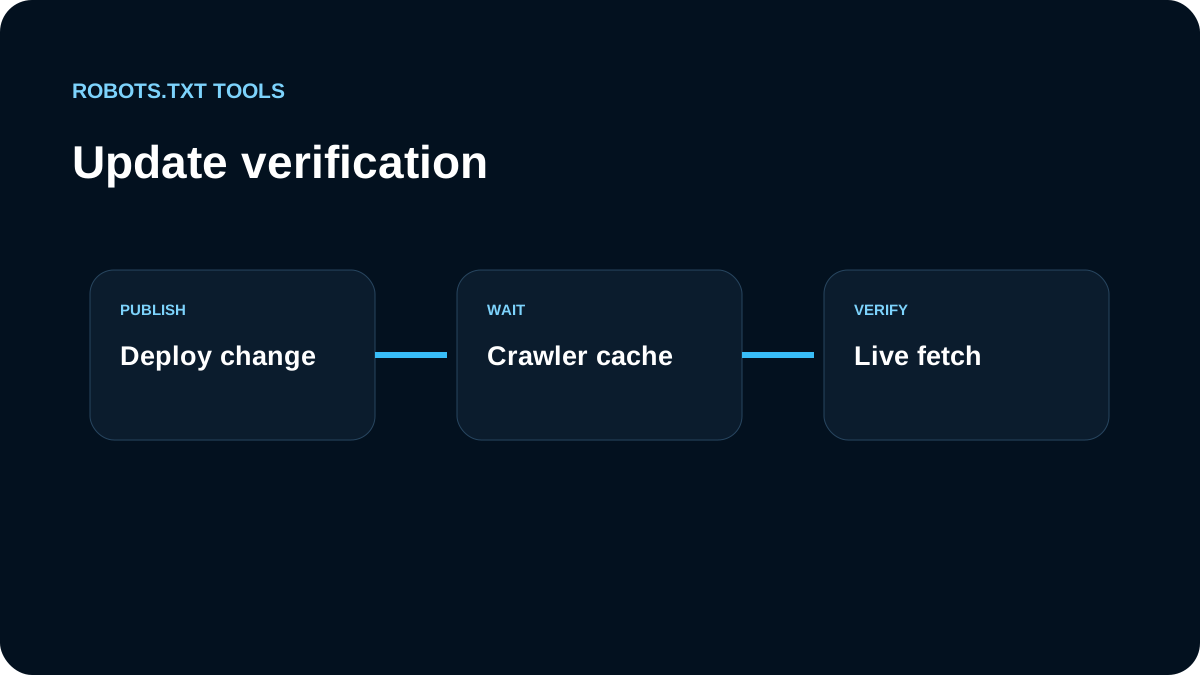
Wenn eine Änderung scheinbar ignoriert wird, trennen wir Repository, öffentliche Antwort und Crawler-Cache.
Wir prüfen zuerst Production
Wir rufen den exakten Host ab und notieren Status, finale URL und Body. Ein falsches Deployment oder ein altes CDN-Objekt ist kein Google-Cache-Problem.
Wir berücksichtigen normalen Cache
Google dokumentiert, dass robots.txt üblicherweise ungefähr 24 Stunden gecacht wird, mit möglichen Abweichungen.
Wir prüfen jede Origin separat
Apex, www und Subdomains können unterschiedliche Versionen liefern. Zusätzlich verfolgen wir Build, CDN, Reverse Proxy und dynamische Generierung.
Fehlerstatus ändern die Diagnose
Ein 5xx oder 429 ist nicht dasselbe wie ein 200 mit altem Inhalt. HTTP-Auslieferung kommt vor Regellogik.
Wir verifizieren live
Der Checker zeigt die aktuelle Datei, der Tester prüft konkrete URLs. Search Console und Logs helfen, Crawler-Zustand von Delivery-Zustand zu trennen.
Die dokumentierte Cache-Dauer ist unser Ausgangspunkt
Google beschreibt für robots.txt typischerweise einen Cache von etwa 24 Stunden. Bei Timeouts oder 5xx kann die alte Version länger verwendet werden; Cache-Control kann ebenfalls Einfluss haben. Deshalb bedeutet eine korrekte Produktionsdatei nicht zwingend sofort verändertes Crawler-Verhalten.
Zeigt unser Checker noch alten Text, untersuchen wir Deployment und CDN. Ist die Live-Datei neu, aber das Verhalten alt, ist normaler Crawler-Cache plausibel. Bei Serverfehlern beheben wir zuerst die Verfügbarkeit.
Vorher-/Nachher-Evidence spart Fehländerungen
Bei kritischen Updates speichern wir alten Body, Deployment-Zeitpunkt, Status, finale URL, Header und neuen Body. Damit unterscheiden wir Crawler-Cache, Edge-Cache und Rollback, ohne die Datei erneut auf Verdacht zu ändern. Mehrere Änderungen während derselben Cache-Phase erschweren die Ursachenanalyse.