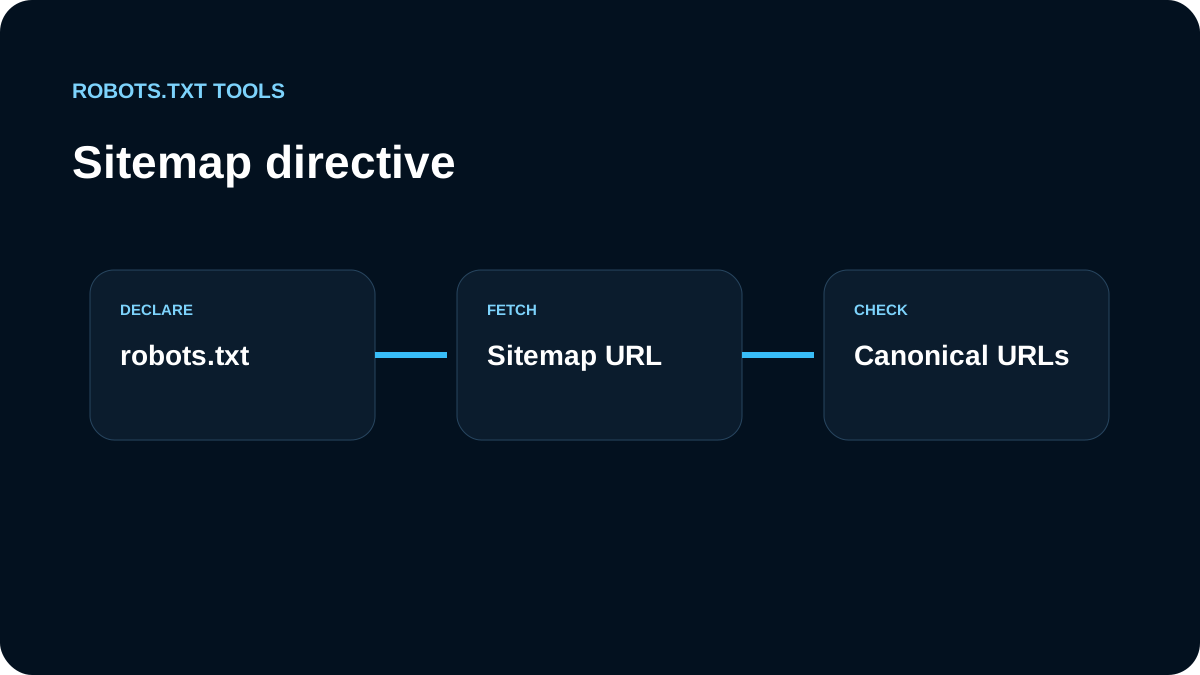
Wir behandeln Sitemap: als Discovery-Hinweis und nicht als Allow- oder Disallow-Regel.
Wir prüfen zuerst die Sitemap
Vor einer Änderung öffnen wir die XML-Datei, prüfen HTTP-Status, HTTPS, kanonischen Host und die enthaltenen URLs. Danach verwenden wir eine absolute URL:
Sitemap: https://example.com/sitemap.xml
Relative Angaben wie Sitemap: /sitemap.xml vermeiden wir.
Mehrere Sitemaps sind möglich
Mehrere Sitemap:-Zeilen sind zulässig. Wenn ein stabiler Sitemap-Index existiert, verweisen wir meist auf diesen, damit robots.txt nicht zu einer zweiten Dateiliste wird.
Sitemap: https://example.com/sitemap-index.xml
Host und Subdomains bleiben getrennt
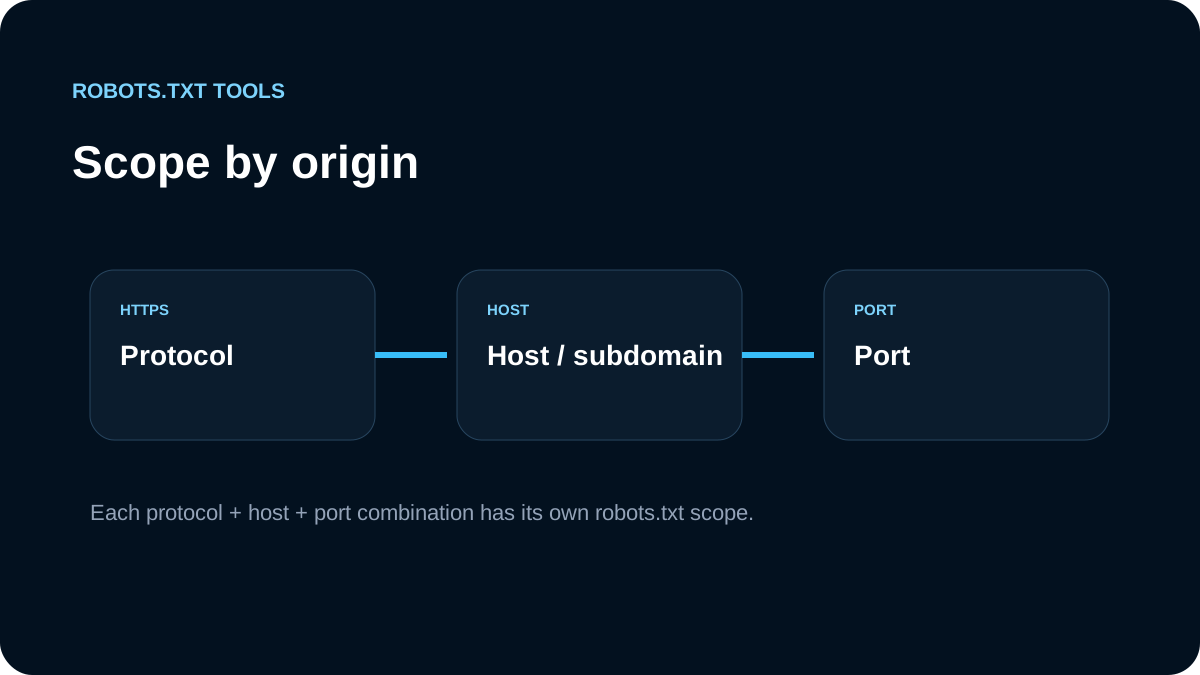
example.com und shop.example.com haben eigene robots.txt-Bereiche. Bei mehreren Hosts prüfen wir jede wichtige Origin und nutzen bei Scope-Fragen den Subdomain-Ratgeber.
Search Console ergänzt die Kontrolle
Die robots.txt-Zeile unterstützt Discovery, ersetzt aber kein Monitoring. Auch eine erreichbare Sitemap kann Redirects, noindex-URLs oder nicht-kanonische Seiten enthalten.
Wir prüfen Production nach dem Release
Wir öffnen /robots.txt, jeden referenzierten Sitemap-Link und Stichproben aus der XML. Danach verwenden wir Checker, Validator und bei Regeländerungen den Tester.
Was eine Sitemap-Zeile leisten kann – und was nicht
Sitemap: hilft Crawlern beim Auffinden der XML-Datei, macht die enthaltenen URLs aber nicht automatisch indexierbar und überschreibt keine Disallow-Regeln. Wir verwenden eine absolute URL mit Protokoll und Host, prüfen die Produktionsdomain und bevorzugen einen stabilen Sitemap-Index, wenn dieser die untergeordneten Dateien bereits verwaltet.
Eine Sitemap auf einem anderen Host kann technisch korrekt sein. Trotzdem prüfen wir Eigentümer, Inhalt und Zweck. Bei Migrationen müssen Redirects, Canonical, Sitemap und Search Console dieselbe Zielarchitektur widerspiegeln; eine gültige Zeile kann sonst weiterhin einen alten Host bewerben.
Unsere Prüfung vor der Veröffentlichung
Wir öffnen jede referenzierte Sitemap, prüfen HTTP-Status, kanonischen Host, öffentliche URLs und eine Stichprobe indexierbarer Seiten. Robots.txt ist dabei nur der Discovery-Pfad. Ein fehlerfreier Verweis kann eine XML-Datei mit Redirects, noindex-URLs oder veralteten Canonicals nicht reparieren.