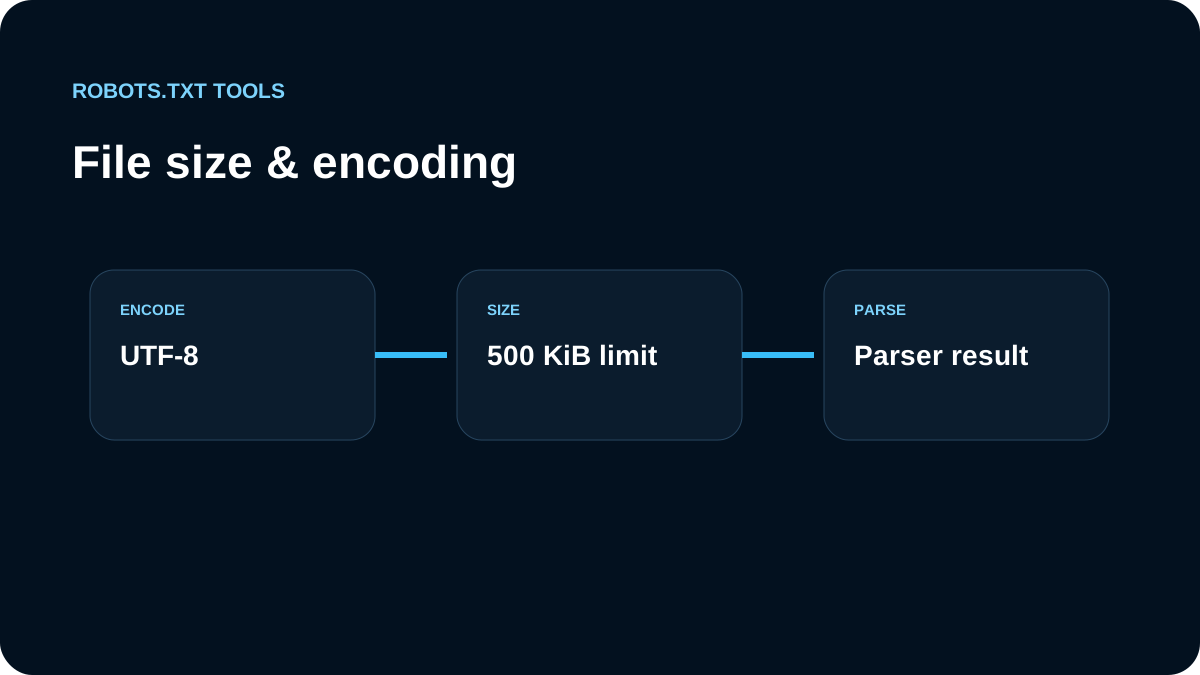
Wir messen die Datei, die Production tatsächlich liefert. Google dokumentiert ein Limit von 500 KiB; Inhalt hinter dieser Grenze kann ignoriert werden.
Wir halten UTF-8 konsistent
Legacy-Encoding und ungültige Bytes vermeiden wir. Bei nicht-ASCII-Pfaden prüfen wir Text und URL-Escaping gemeinsam.
Wir reduzieren Wiederholungen
Große Dateien enthalten oft generierte Einzel-URLs, Kommentare oder duplizierte Gruppen. Stabile Pfadregeln sind wartbarer als tausende Ausnahmen.
Wir validieren nach jeder Vereinfachung
Eine kürzere Wildcard kann zu breit werden. Deshalb verwenden wir den Validator und testen reale URLs mit dem Tester.
Wir prüfen die HTTP-Auslieferung
CDN, Redirects oder dynamische Generierung können trotz korrektem Quelltext etwas anderes liefern. Der Checker bestätigt Status, Inhalt und Production-Version.
Der 500-KiB-Grenzwert ist praktisch relevant
Google verarbeitet robots.txt aktuell nur bis ungefähr 500 KiB; Inhalt dahinter kann ignoriert werden. Wir planen deshalb mit deutlichem Abstand zum Limit. Eine wichtige Regel, die erst nach dem verarbeiteten Bereich steht, kann im Repository vorhanden sein und für den Crawler faktisch fehlen.
Encoding-Probleme sehen oft wie Matching-Probleme aus
Wir prüfen die ausgelieferten UTF-8-Bytes, nicht nur die Darstellung im Editor. Dazu gehören BOM, Ersatzzeichen, nicht-ASCII-Pfade, Groß-/Kleinschreibung und percent-encoded Varianten. Außerdem stellen wir sicher, dass wirklich Text ausgeliefert wird und nicht eine HTML-Fehlerseite mit irreführendem Status.
Wird die Datei sehr groß, suchen wir zuerst nach doppelten Gruppen, per-URL-Regeln und riesigen Bot-Listen. Ein kleinerer, erklärbarer Regelsatz ist leichter zu auditieren und weniger anfällig für Grenzwert- oder Wartungsfehler.