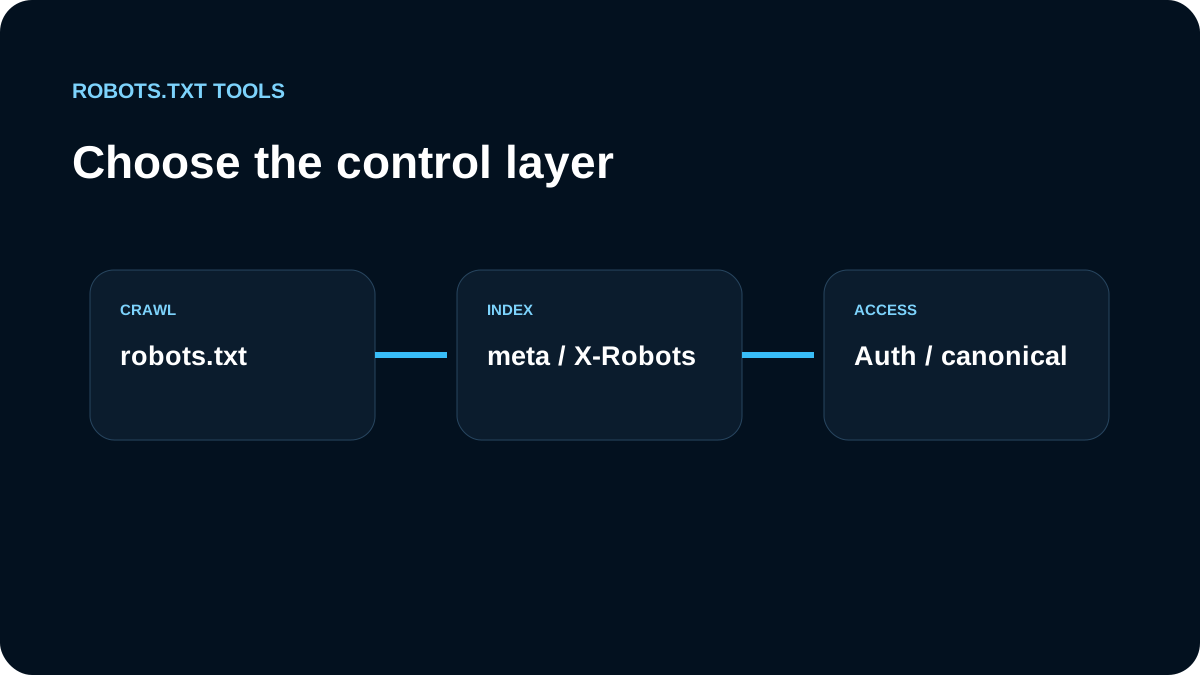
Wir wählen die Steuerung nach dem Problem: robots.txt für Crawling, noindex für Indexierung, canonical für Duplikate, Redirects für Umzüge und Authentifizierung für private Inhalte.
Robots.txt beantwortet eine Crawl-Frage
Disallow ist kein zuverlässiger Löschbefehl für den Index.
Meta Robots muss gelesen werden können
<meta name="robots" content="noindex">
Blockiert robots.txt dieselbe URL, kann der Crawler noindex nicht verarbeiten.
X-Robots-Tag arbeitet im HTTP-Header
X-Robots-Tag: noindex
Das ist besonders für PDFs und andere Nicht-HTML-Ressourcen nützlich.
Canonical ist keine Zugriffskontrolle
canonical konsolidiert Signale; private Inhalte schützen wir mit Authentifizierung oder Autorisierung.
Unser Entscheidungsweg
Privat → Authentifizierung. Öffentlich, aber nicht im Index → noindex/X-Robots-Tag. Duplikat → canonical oder Redirect. Crawl-Waste → robots.txt prüfen. Danach kontrollieren wir Production mit dem Checker.
Die Kontrollen lösen unterschiedliche Probleme
Disallow steuert Crawling, noindex die Aufnahme in Suchergebnisse, wenn der Crawler die Seite lesen kann. X-Robots-Tag ist für PDFs und andere Nicht-HTML-Ressourcen geeignet, Canonical konsolidiert Duplikate und Authentifizierung schützt private Inhalte. Wir behandeln diese Ebenen nicht als austauschbare Verstärkung.
Eine Seite gleichzeitig in robots.txt zu blockieren und mit noindex zu versehen kann sogar kontraproduktiv sein: Der Crawler kann die Indexierungsanweisung nicht lesen. Für öffentliche URLs, die aus Suchergebnissen verschwinden sollen, lassen wir den Abruf zu und setzen die Indexierungsdirektive. Vertrauliche Inhalte gehören hinter echten Zugriffsschutz.
Wir starten mit dem Symptom
Geht es um Crawl-Budget, Suchergebnis-Entfernung, Duplikate, Migration oder Datenschutz? Erst nach dieser Klärung wählen wir die primäre Kontrolle und prüfen robots.txt, HTML/Headers und die endgültige Produktionsantwort gemeinsam.