
panduan
Robots.txt untuk crawler AI: pencarian, pelatihan, dan akses
Bagaimana mengizinkan pencarian AI tanpa membuka semua crawler untuk pelatihan?
Baca panduan →Basis pengetahuan
Panduan praktis tentang crawling, pengindeksan, cakupan host, sitemap, parameter URL, cache, dan troubleshooting robots.txt.
panduan
Bagaimana mengizinkan pencarian AI tanpa membuka semua crawler untuk pelatihan?
Baca panduan →
panduan
Apakah robots.txt bisa mencegah pengindeksan dan kapan sebaiknya memakai noindex?
Baca panduan →
panduan
Apakah Crawl-delay bekerja untuk Googlebot dan bagaimana mengurangi beban crawling berlebihan?
Baca panduan →
panduan
Aturan mana yang menang jika beberapa Allow dan Disallow cocok dengan URL yang sama?
Baca panduan →
panduan
Apa yang dilakukan Googlebot saat robots.txt mengembalikan 404, 403, 429, atau 500?
Baca panduan →
panduan
Di mana menambahkan Sitemap di robots.txt dan bagaimana memeriksa beberapa referensi?
Baca panduan →
panduan
Apakah robots.txt domain utama berlaku untuk subdomain, HTTP, HTTPS, atau port lain?
Baca panduan →
panduan
Bagaimana mengontrol URL berparameter dan facet tanpa memblokir halaman penting?
Baca panduan →
panduan
Apa yang terjadi jika robots.txt lebih dari 500 KiB atau bukan UTF-8?
Baca panduan →
panduan
Haruskah memakai robots.txt, meta robots, X-Robots-Tag, canonical, atau autentikasi?
Baca panduan →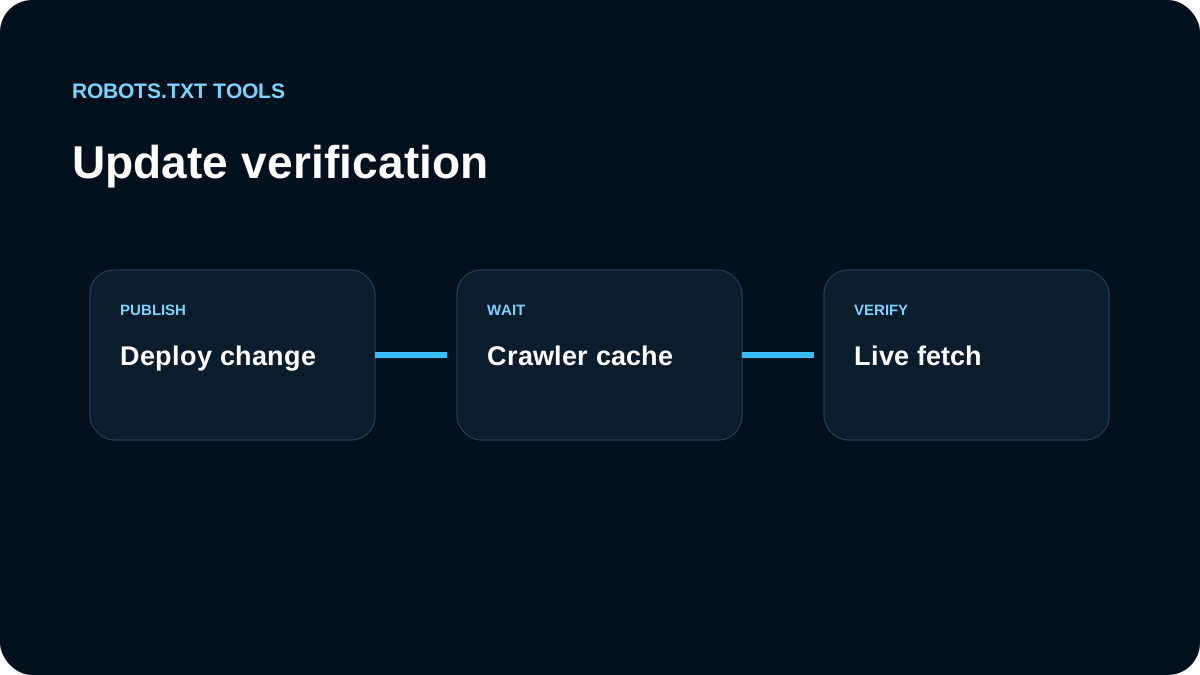
panduan
Berapa lama robots.txt disimpan dalam cache dan bagaimana membedakan cache crawler dari kegagalan deploy?
Baca panduan →
panduan
Bagaimana menjaga staging dari hasil pencarian tanpa memakai robots.txt sebagai security?
Baca panduan →