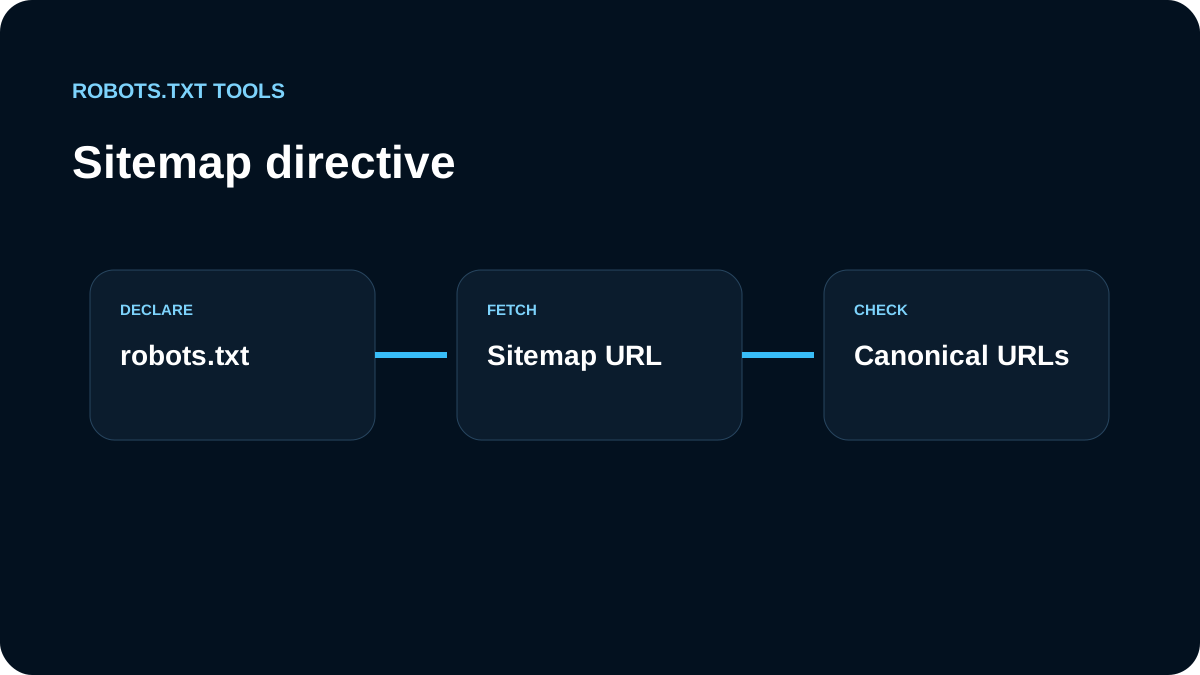
Kami memperlakukan Sitemap: sebagai referensi discovery, bukan aturan Allow atau Disallow.
Kami memeriksa sitemap lebih dulu
Kami membuka XML, memeriksa status HTTP, HTTPS, host canonical, dan URL yang tercantum. Setelah itu kami memakai URL absolut:
Sitemap: https://example.com/sitemap.xml
Beberapa sitemap atau satu index
Beberapa baris Sitemap: valid. Jika ada sitemap index yang stabil, kami biasanya merujuk index tersebut agar robots.txt tidak menjadi inventaris kedua.
Sitemap: https://example.com/sitemap-index.xml
Kami memisahkan host
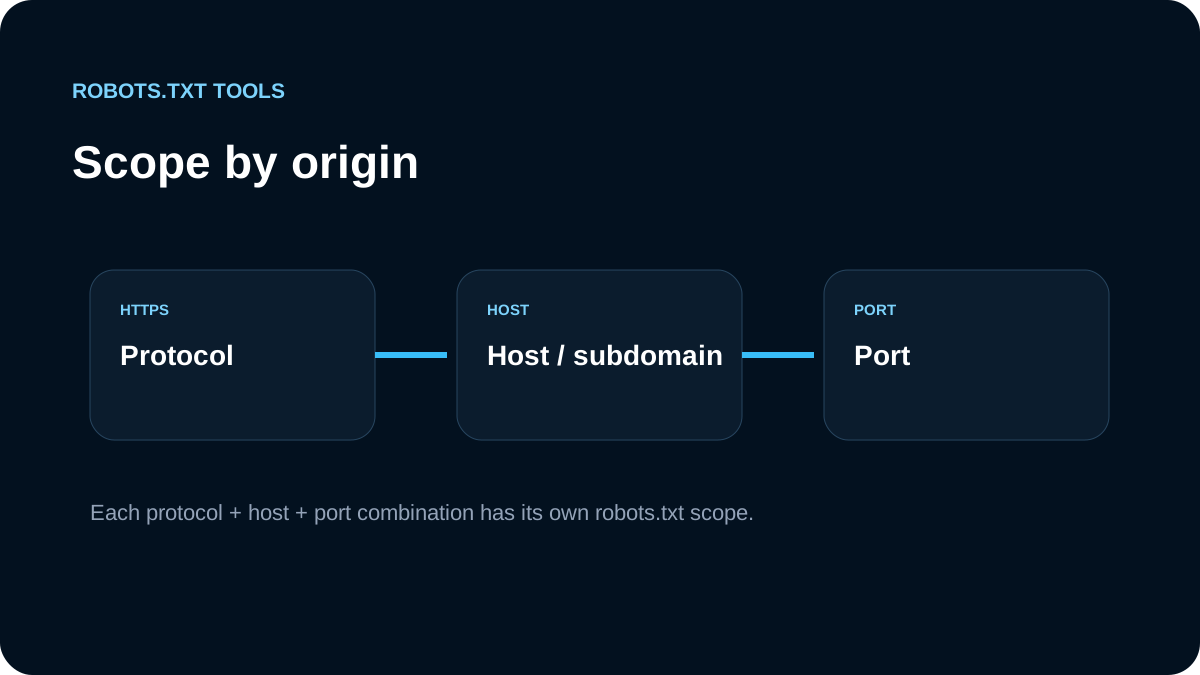
Robots.txt domain utama tidak otomatis mengatur subdomain. Untuk arsitektur multi-host, kami memeriksa setiap origin dan memakai panduan subdomain bila scope menjadi masalah utama.
Search Console tetap berguna
Referensi sitemap membantu discovery, tetapi tidak menjamin kualitas XML. Kami juga memeriksa redirect, noindex, dan URL non-canonical.
Kami memverifikasi production
Setelah publish, kami membuka /robots.txt, setiap sitemap, lalu memakai checker dan validator.
Apa yang dapat dan tidak dapat dilakukan baris Sitemap
Sitemap: membantu crawler menemukan XML, tetapi tidak membuat URL otomatis dapat diindeks dan tidak menimpa aturan Disallow. Kami memakai URL absolut dengan protokol dan host, memastikan domain produksi benar, dan memilih sitemap index yang stabil jika file tersebut sudah mengelola sitemap anak.
Sitemap di host berbeda bisa valid, tetapi ownership dan isinya tetap kami verifikasi. Saat migrasi, redirect, canonical, sitemap, dan Search Console harus menunjuk arsitektur target yang sama; baris yang valid secara teknis tetap bisa mempromosikan host lama.
Pemeriksaan sebelum publish
Kami membuka setiap sitemap, mengecek status HTTP, host kanonis, URL publik, dan sampel halaman yang memang layak diindeks. robots.txt hanya membantu discovery; referensi yang benar tidak memperbaiki XML yang penuh redirect, noindex, atau URL non-kanonis.