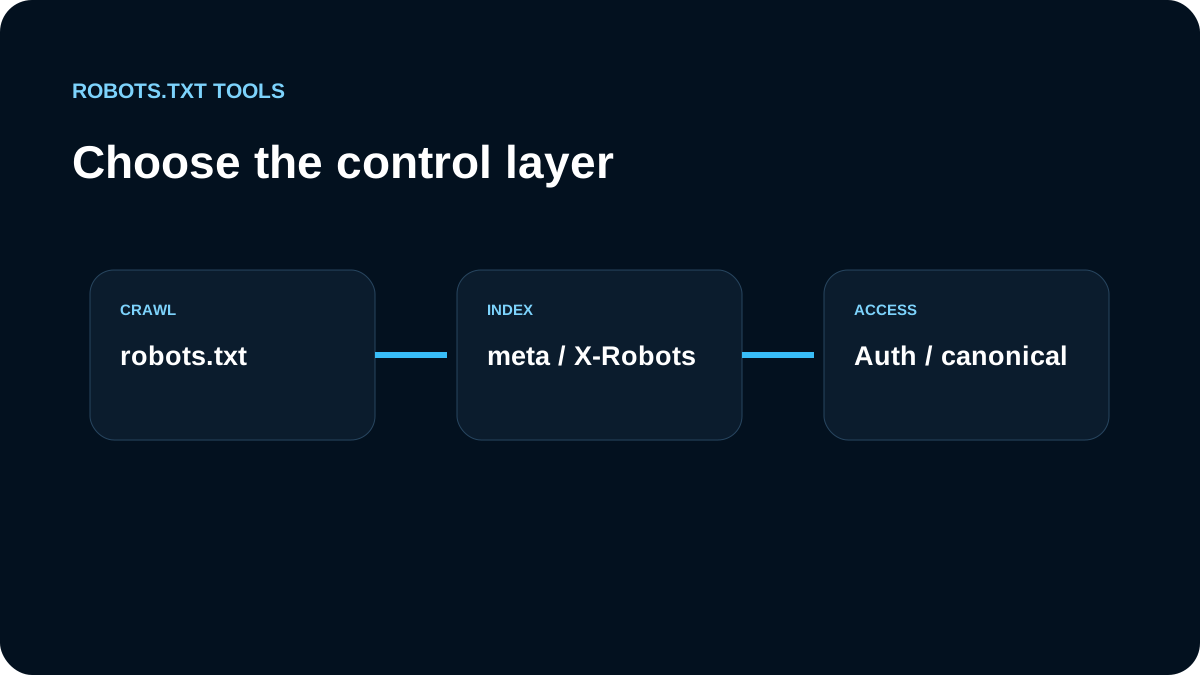
Kami memilih kontrol berdasarkan tujuan: robots.txt untuk crawling, noindex untuk indexing, canonical untuk duplikat, redirect untuk pemindahan, dan autentikasi untuk konten privat.
Robots.txt menjawab masalah crawl
Disallow bukan perintah penghapusan index yang andal.
Meta robots harus dapat dibaca
<meta name="robots" content="noindex">
Jika URL diblokir di robots.txt, crawler mungkin tidak membaca noindex.
X-Robots-Tag bekerja di HTTP header
X-Robots-Tag: noindex
Ini berguna untuk PDF dan resource non-HTML.
Canonical bukan kontrol akses
canonical mengonsolidasikan signal. Konten sensitif memakai autentikasi atau authorization nyata.
Urutan keputusan kami
Privat → autentikasi. Publik tetapi tidak di index → noindex/X-Robots-Tag. Duplikat → canonical/redirect. Crawl waste → evaluasi robots.txt. Setelah itu kami memeriksa production dengan checker.
Setiap kontrol menyelesaikan masalah berbeda
Disallow mengatur crawling; noindex meminta agar halaman tidak masuk hasil ketika crawler dapat membacanya; X-Robots-Tag cocok untuk PDF dan resource non-HTML; canonical menggabungkan sinyal duplikat; autentikasi melindungi konten privat. Kami tidak menumpuk semuanya hanya sebagai “pengaman tambahan”.
Memblokir halaman lewat robots.txt sekaligus memberi noindex dapat membuat crawler tidak pernah membaca directive tersebut. Untuk URL publik yang harus keluar dari hasil, kami membiarkan crawl lalu memberi noindex. Untuk data privat, kami memakai access control nyata.
Kami mulai dari gejala
Apakah masalahnya crawl waste, tampil di search, duplikasi, migrasi, atau privasi? Setelah itu kami memilih kontrol utama dan hanya menambah kontrol lain jika interaksinya jelas, lalu memeriksa robots.txt, HTML/header, dan response final di production.