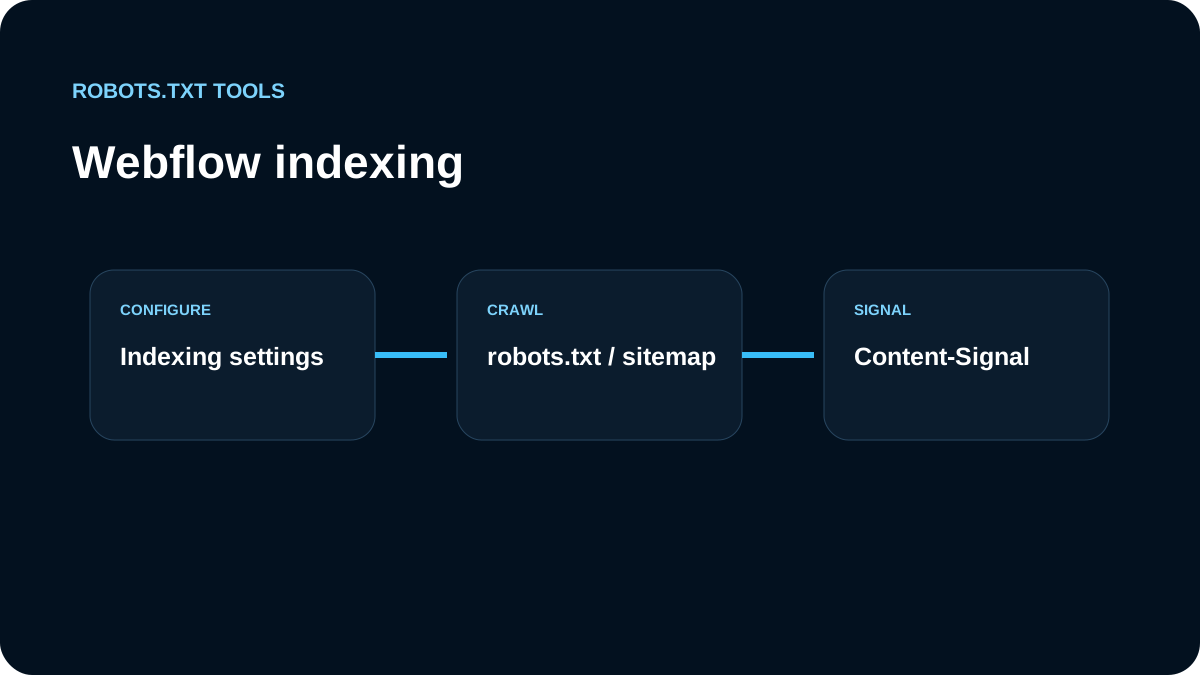
En Webflow tratamos robots.txt como parte del flujo de publicación. Los controles están en Site settings → SEO → Indexing, pero solo la versión publicada cuenta.
Comprobamos producción primero
Abrimos /robots.txt y buscamos Disallow demasiado amplios, dominio incorrecto y líneas Sitemap: duplicadas.
Revisamos el sitemap automático
Webflow suele añadir la referencia al sitemap. Antes de escribir otra, comprobamos si ya existe. En reverse proxy o multi-site revisamos la opción documentada para sustituir esa referencia cuando la arquitectura lo exige.
Guardar no es publicar
Nuestro flujo es editar, guardar, publish, volver a solicitar /robots.txt y revisar cache si la respuesta sigue antigua.
Content-Signal es otra capa
Content-Signal expresa preferencias sobre uso de contenido por sistemas de IA. No lo tratamos como sustituto de robots.txt, que decide acceso de crawling.
Probamos reglas específicas
Usamos el tester y el validator antes del release. Para previews privados usamos autenticación, no robots.txt.
La comprobación final incluye Indexing, publish, sitemap, dominio canónico, Content-Signal y respuesta viva.