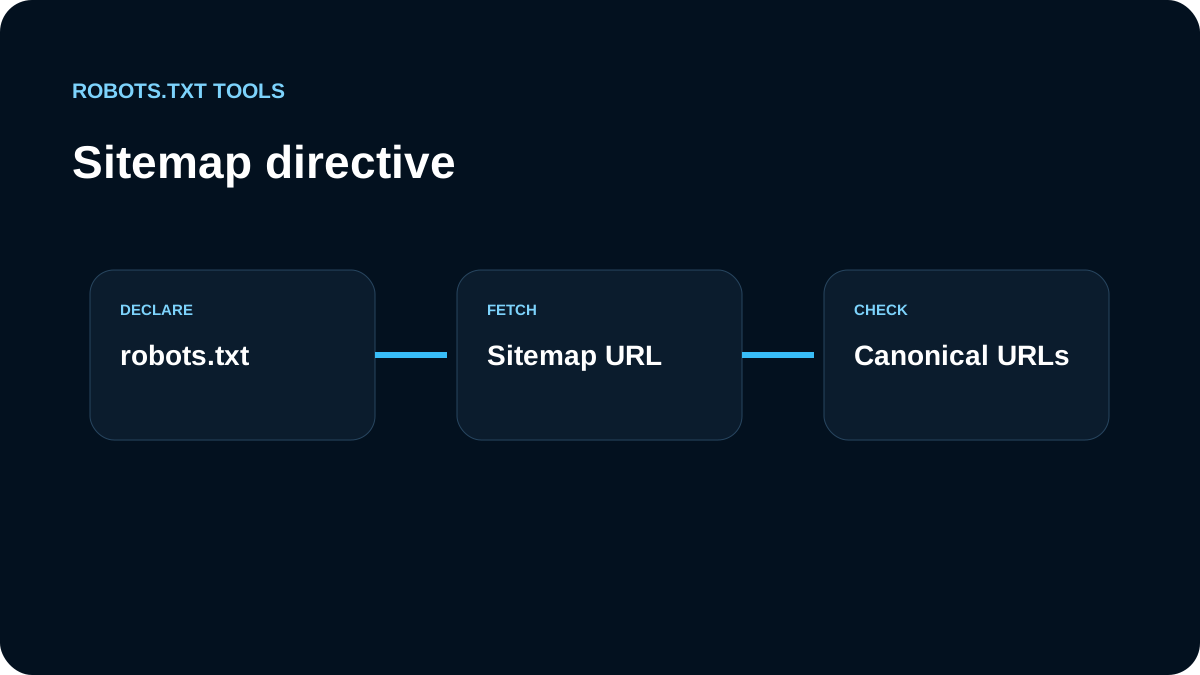
Nós tratamos Sitemap: como referência de descoberta, não como permissão de crawling.
Conferimos o XML primeiro
Abrimos o sitemap, verificamos status HTTP, HTTPS, host canônico e URLs indexáveis. Só então adicionamos uma URL absoluta:
Sitemap: https://example.com/sitemap.xml
Índice ou vários arquivos
Várias linhas Sitemap: são válidas. Quando existe um sitemap-index.xml estável, preferimos apontar para o índice para não manter a mesma lista em dois lugares.
Separamos hosts
O robots.txt do domínio principal não cobre automaticamente subdomínios. Em arquiteturas com loja, docs ou CDN, conferimos cada origem e usamos a guia de subdomínios quando o escopo é a dúvida principal.
Search Console continua útil
A linha no robots.txt ajuda descoberta, mas não substitui monitoramento. Um sitemap pode estar acessível e ainda listar redirects, noindex ou URLs não canônicas.
Validamos produção
Abrimos /robots.txt, cada sitemap e uma amostra de URLs; depois usamos o checker e o validator. Nosso padrão é uma referência absoluta, canônica e realmente publicada.
O que a linha Sitemap faz — e o que não faz
Sitemap: ajuda crawlers a descobrir o XML, mas não torna URLs indexáveis e não substitui regras de crawling. Usamos URL absoluta com protocolo e host, verificamos se o arquivo pertence ao ambiente de produção e preferimos um sitemap index estável quando ele já organiza os arquivos filhos.
Sitemaps em outro host podem ser válidos, mas conferimos ownership e conteúdo antes de anunciá-los. Em migrações, robots.txt, redirects, canonical, sitemap e Search Console precisam apontar para a mesma arquitetura; uma linha tecnicamente correta ainda pode promover um host antigo.
Checklist antes de publicar
Abrimos cada sitemap, verificamos status HTTP, host canônico, URLs públicas e uma amostra de páginas indexáveis. Também evitamos manter em robots.txt uma lista duplicada de todos os sitemaps filhos quando o índice já cumpre esse papel. A diretiva facilita descoberta; a qualidade do XML continua sendo o fator principal.