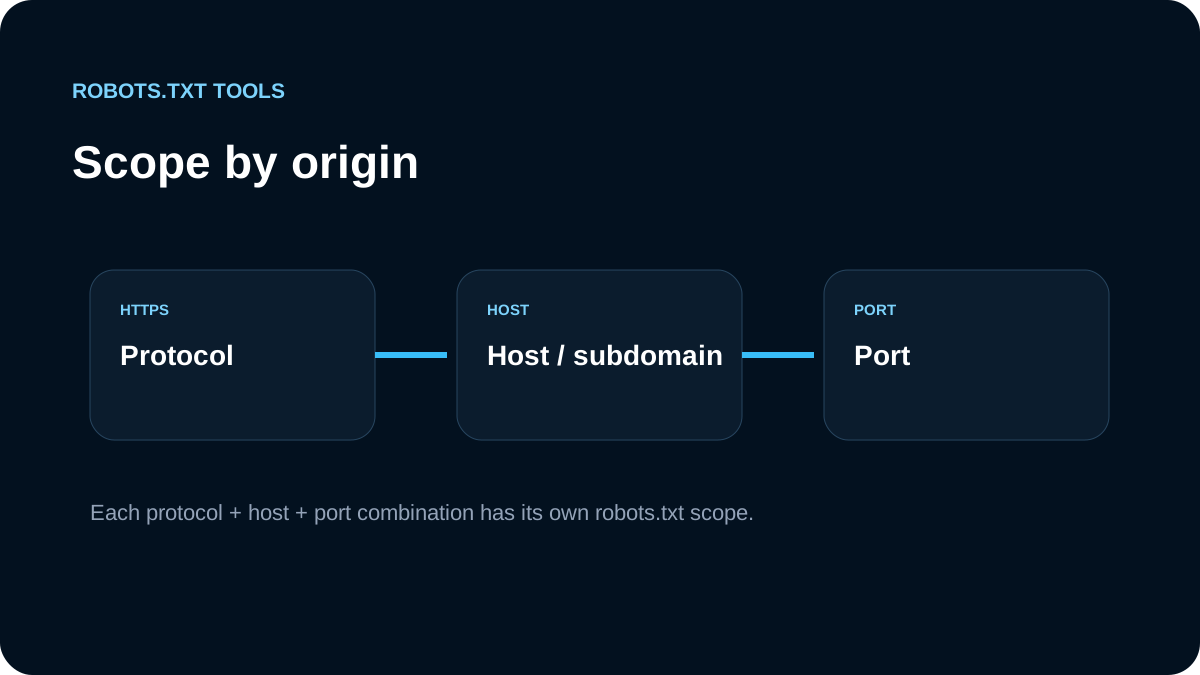
Quando uma regra parece correta mas não funciona, nós conferimos o escopo antes da sintaxe. Robots.txt é ligado à origem: protocolo, host e porta.
Separamos as origens
https://example.com/robots.txt
https://www.example.com/robots.txt
https://shop.example.com/robots.txt
http://example.com/robots.txt
https://example.com:8443/robots.txt
Não existe herança automática entre esses endereços.
Criamos um inventário
Listamos produção, www, loja, docs, preview e staging. Abrimos /robots.txt em cada host e identificamos quem entrega a resposta: framework, CMS, CDN ou proxy.
Testamos a URL no host correto
Uma URL da loja é testada contra a política da loja. Usamos o tester para ver a regra vencedora e o checker para confirmar o arquivo público.
Staging exige segurança real
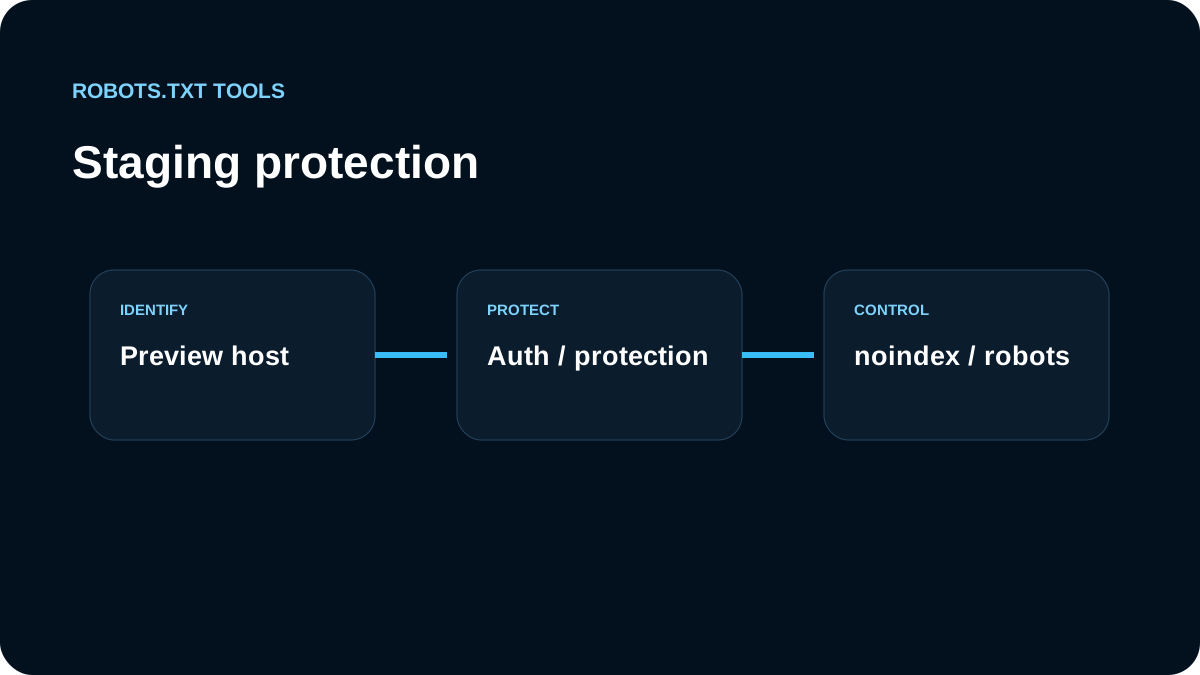
Conteúdo privado fica atrás de autenticação ou outro controle de acesso. Disallow: / não é segurança. Em previews públicos também avaliamos noindex.
Nossa revisão final
Conferimos HTTP/HTTPS, www, subdomínios, porta, ownership do deploy e ambientes antigos de migração. Pensar por origem evita corrigir o arquivo certo no lugar errado.
Escopo é por origem
robots.txt pertence à combinação de protocolo, host e porta. O arquivo de https://example.com não controla automaticamente shop.example.com, www.example.com, HTTP ou outra porta. Em auditorias, listamos todos os hosts públicos e abrimos o /robots.txt de cada um.
Isso evita um erro comum em migrações: corrigir o arquivo do domínio principal enquanto um subdomínio continua servindo regras antigas por outro CMS, CDN ou plataforma.
Redirect não funde políticas
Um redirect de www para o domínio raiz não significa que devemos assumir qual robots.txt o crawler recebeu. Inspecionamos a cadeia específica de /robots.txt, identificamos quem serve a resposta e corrigimos essa camada. Também documentamos ownership por origem — aplicação, CDN, ecommerce, documentação ou marketing — para que incidentes futuros não virem alterações aleatórias em arquivos que não controlam o host afetado.