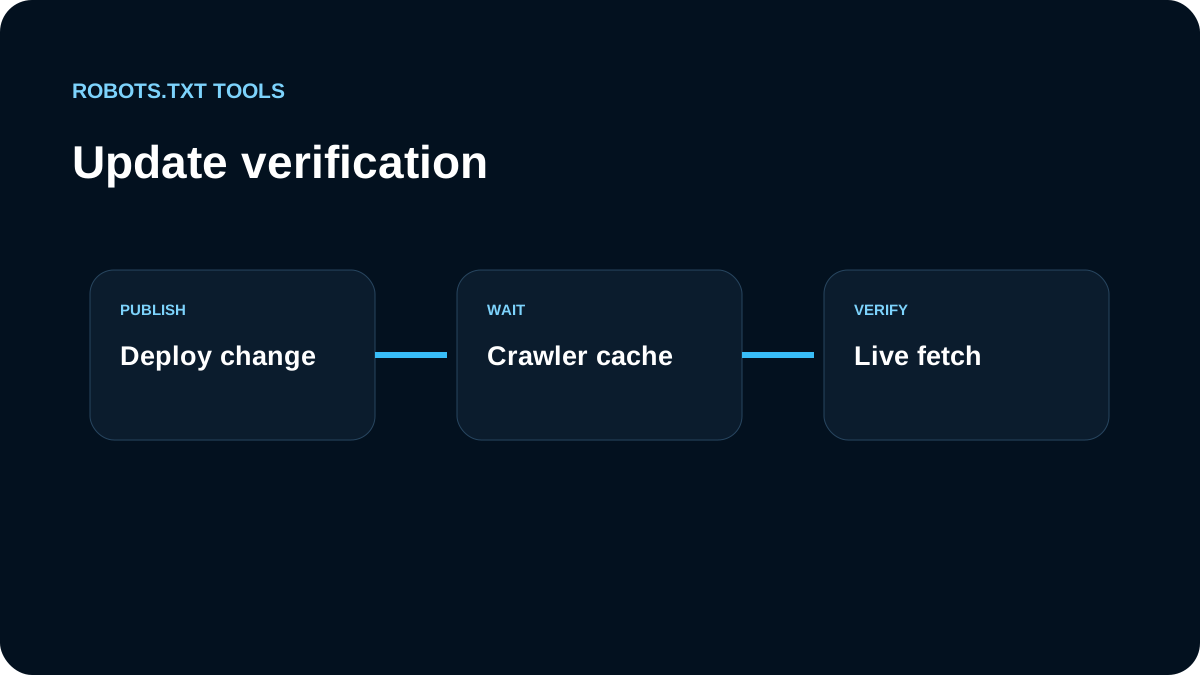
Quando uma mudança parece ignorada, nós separamos código, resposta pública e cache do crawler.
Conferimos produção primeiro
Abrimos o host exato e registramos status, URL final e corpo. CDN antiga ou deploy errado não é cache do Google.
Consideramos a janela de cache
O Google documenta cache normalmente em torno de 24 horas, com variações conforme disponibilidade e headers.
Revisamos host e entrega
Apex, www e subdomínios podem ter versões diferentes. Também seguimos build, CDN, proxy e geração dinâmica.
Status de erro muda o diagnóstico
5xx ou 429 não é igual a um 200 com conteúdo antigo. Primeiro entendemos a resposta HTTP.
Validamos o arquivo vivo
Usamos o checker, o tester e, quando disponível, logs/Search Console. Só editamos novamente quando a versão pública realmente está errada.
A janela de cache ajuda a organizar o diagnóstico
O Google informa que robots.txt normalmente fica em cache por cerca de 24 horas, podendo permanecer mais tempo quando a atualização falha por timeout ou 5xx. Headers de cache também podem influenciar. Por isso um arquivo correto em produção não significa mudança imediata no comportamento do crawler.
Se o checker ainda mostra texto antigo, investigamos deploy e CDN. Se a resposta pública já está nova, mas o crawler parece usar regras antigas, cache normal é uma hipótese plausível. Se existem erros de disponibilidade, corrigimos isso antes de interpretar o matching.
Guardamos evidência antes/depois
Registramos body anterior, horário do deploy, status HTTP, URL final, headers e body novo. Isso permite distinguir cache do crawler, cache do edge e rollback sem publicar outra mudança especulativa. Reeditar a regra a cada poucos minutos só embaralha a linha do tempo.