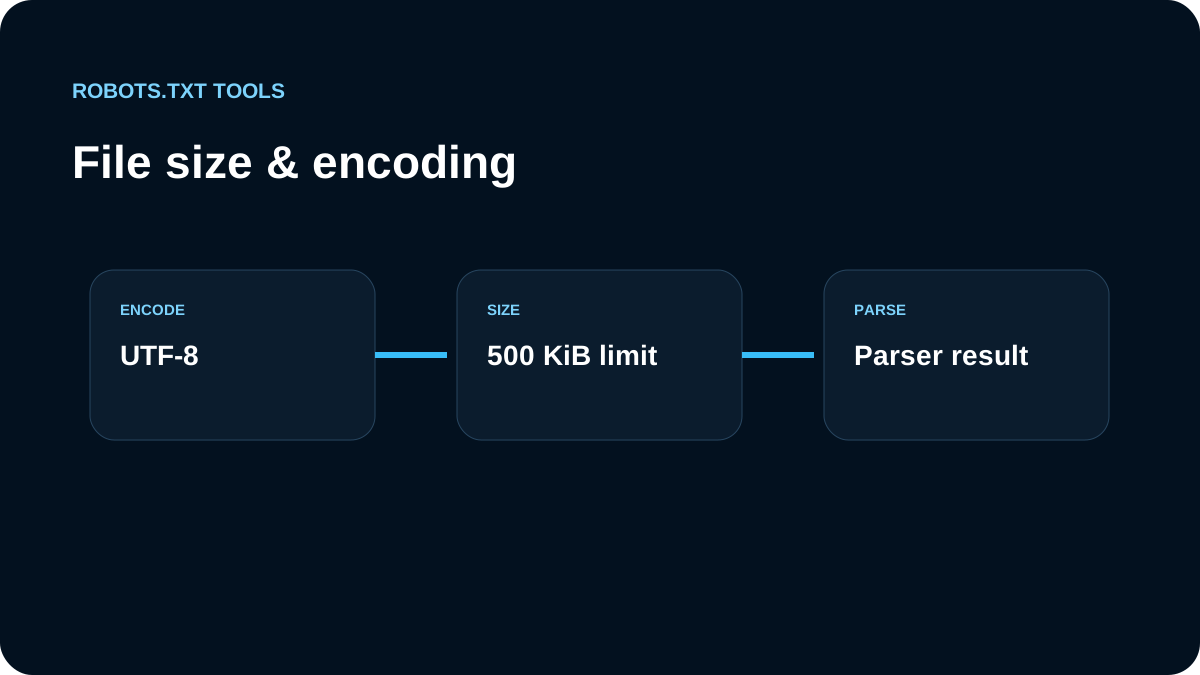
Nós medimos o arquivo entregue em produção. O Google documenta limite de 500 KiB; conteúdo depois desse tamanho pode ser ignorado.
Mantemos UTF-8 consistente
Evitamos encoding legado e bytes inválidos. Em caminhos não ASCII conferimos texto e escape de URL.
Reduzimos repetição
Arquivos enormes costumam trazer listas por URL, comentários gerados e grupos duplicados. Preferimos padrões claros sem transformar robots.txt em banco de exceções.
Validamos depois de simplificar
Uma regra menor pode ficar ampla demais. Usamos o validator e o tester após alterações estruturais.
Verificamos entrega
CDN, redirects e geração dinâmica ainda podem servir outro conteúdo. O checker confirma status, arquivo e produção.
O limite de 500 KiB muda a prioridade das regras
O Google continua processando robots.txt até cerca de 500 KiB; conteúdo além do limite pode ser ignorado. Por isso deixamos margem e não tratamos 499 KiB como objetivo aceitável. Uma regra importante localizada depois do limite pode existir no repositório e não ser considerada pelo crawler.
Encoding pode parecer problema de matching
Validamos os bytes entregues em UTF-8, não apenas o texto mostrado no editor. Procuramos BOM, caracteres de substituição, diferenças de maiúsculas/minúsculas, caminhos não ASCII e formas percent-encoded. Também confirmamos que o servidor entrega texto, e não uma página HTML de erro mascarada.
Arquivos enormes normalmente merecem simplificação arquitetural: removemos grupos repetidos, regras por URL e listas gigantes de bots quando um padrão estável representa a mesma política. Depois testamos URLs reais novamente para garantir que a redução não alterou o comportamento.