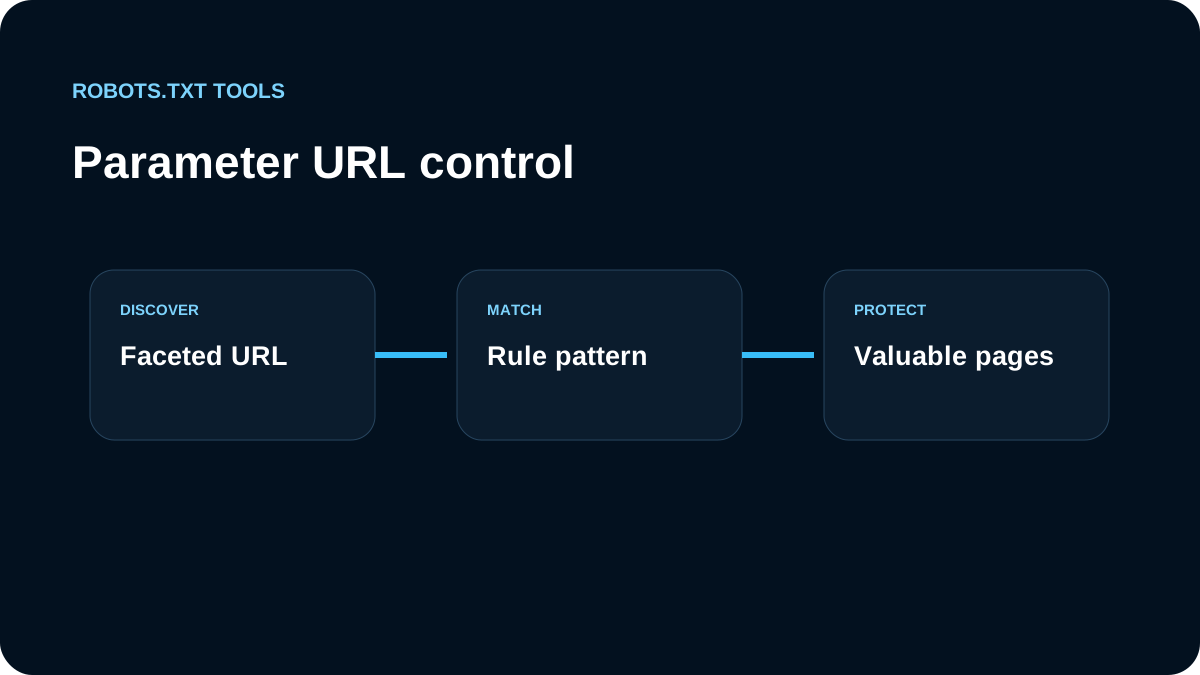
Nós não começamos com Disallow: /*?. Primeiro classificamos o parâmetro: ordenação, filtro, faceta, tracking, sessão, paginação ou busca interna.
Testamos a query string exata
User-agent: *
Disallow: /*?sort=
Rodamos exemplos permitidos e bloqueados no tester porque um wildcard pode atingir muito mais URLs do que parece.
Duplicidade não significa bloqueio automático
Para tracking, canonical, redirects ou links limpos podem resolver melhor. Para uma página pública que não deve aparecer na busca, avaliamos noindex.
Facetas precisam de seleção
Alguns filtros de ecommerce têm valor de busca; combinações profundas podem gerar expansão quase infinita. Nós preservamos estados úteis e bloqueamos apenas o crawl sem valor comprovado.
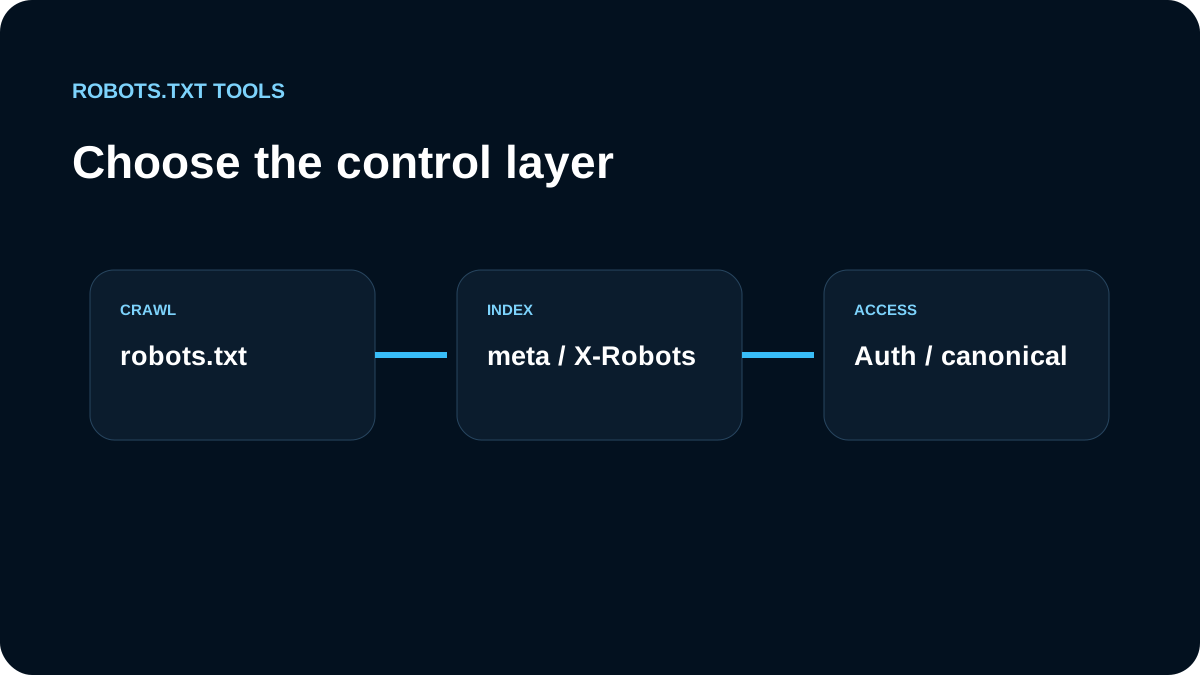
Separamos crawling de indexação
Robots.txt controla acesso do crawler; noindex controla indexação quando a página pode ser lida. A comparação com meta robots ajuda a escolher a camada.
Confirmamos produção
Criamos uma matriz de URLs, validamos regras e repetimos os testes sobre o arquivo vivo com o checker.
Navegação facetada exige uma decisão explícita
A documentação atual do Google trata facetas como uma possível fonte de espaços praticamente infinitos de URLs. Quando essas combinações não precisam aparecer na busca, limitar o crawling pode fazer sentido. Quando precisam ser crawlable, mantemos ordem previsível dos parâmetros, evitamos combinações duplicadas e retornamos 404 real para estados sem resultado.
Tracking, busca interna, ordenação e filtros não são a mesma coisa. Parâmetros de campanha costumam pedir canonical e higiene de links; busca interna raramente merece indexação; ordenação pode ser crawl waste; facetas de categoria, cor ou tamanho podem ter valor como landing page. Não usamos um único wildcard para resolver todos esses casos.
Também reduzimos a geração de URLs
robots.txt não remove links. Revisamos filtros, navegação, paginação, JavaScript e sitemaps para descobrir quem cria combinações inúteis. Se o aplicativo puder deixar de gerar essas URLs, a solução tende a ser mais estável do que ampliar regras para sempre.