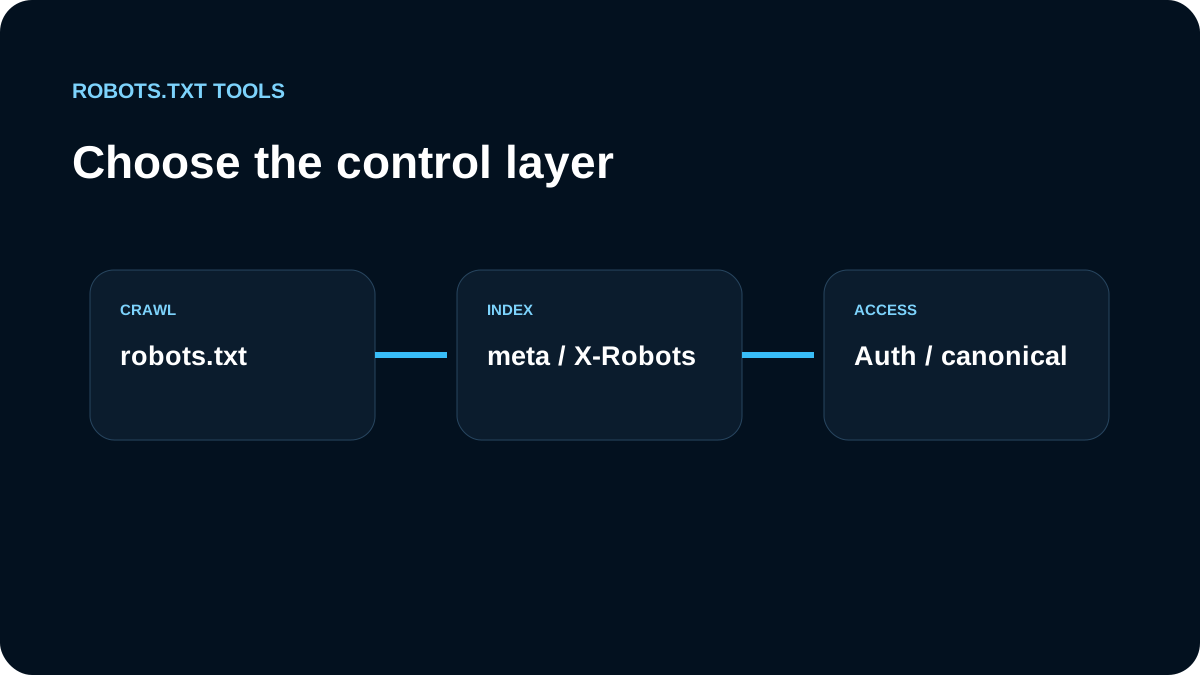
Nós escolhemos a camada pelo problema. Robots.txt controla crawling; noindex controla indexação; canonical consolida duplicatas; redirects movem URLs; autenticação protege conteúdo.
Robots.txt é controle de crawl
Disallow não é pedido confiável de remoção do índice.
Meta robots precisa ser lido
<meta name="robots" content="noindex">
Se o crawler estiver bloqueado no robots.txt, pode não processar esse noindex.
X-Robots-Tag funciona no header
X-Robots-Tag: noindex
É útil para PDF e outros recursos não HTML, desde que a resposta possa ser acessada.
Canonical não protege conteúdo
Canonical consolida sinais; não substitui autenticação. Para informação privada usamos controle de acesso real.
Nossa decisão
Privado → autenticação. Público fora da busca → noindex/X-Robots-Tag. Duplicado → canonical ou redirect. Desperdício de crawl → avaliar robots.txt. Depois verificamos o arquivo com o checker.
Cada controle resolve um problema diferente
Disallow controla crawling; noindex pede exclusão de resultados quando a página pode ser lida; X-Robots-Tag funciona bem para PDFs e outros recursos; canonical consolida duplicados; autenticação protege conteúdo privado. Não tratamos essas camadas como reforços intercambiáveis.
Por exemplo, bloquear uma página em robots.txt e adicionar noindex pode impedir o crawler de ver justamente a diretiva de indexação. Para uma URL pública que precisa sair da busca, mantemos o acesso e usamos noindex. Para conteúdo confidencial, usamos autenticação ou autorização.
Começamos pelo sintoma
Perguntamos se o objetivo é reduzir crawl, remover da busca, consolidar duplicação, mover URL ou impedir acesso. Escolhemos um controle principal e só adicionamos outro quando a interação é clara. Depois verificamos robots.txt, HTML/headers e a resposta final em produção.