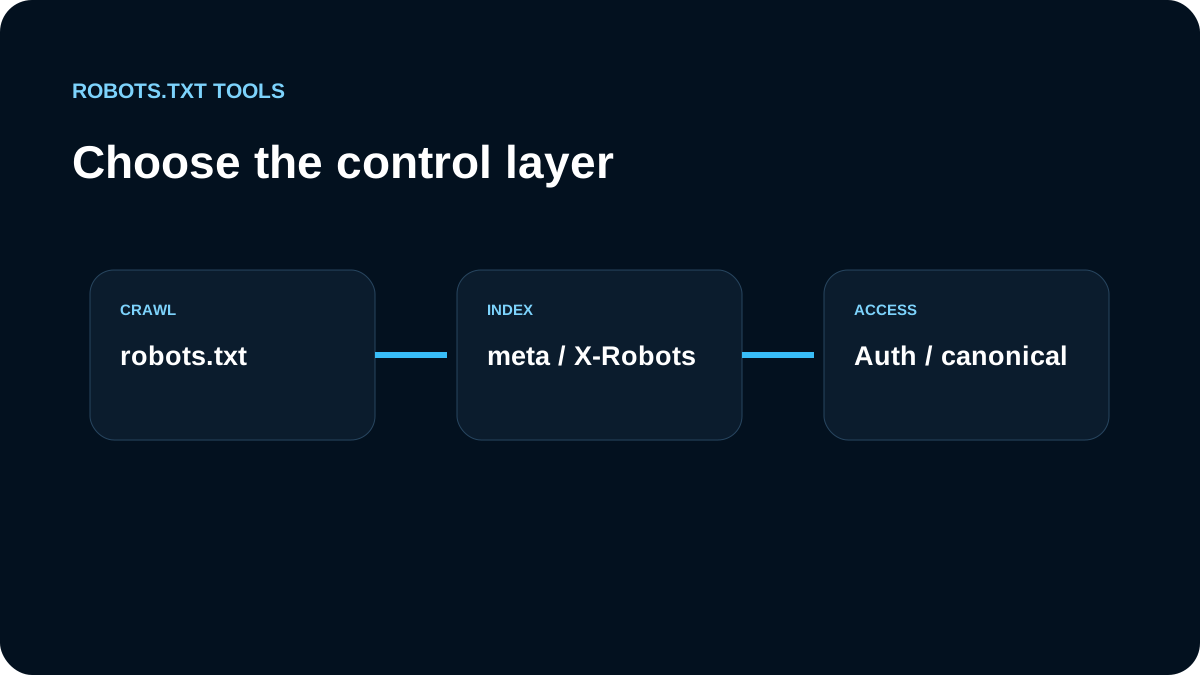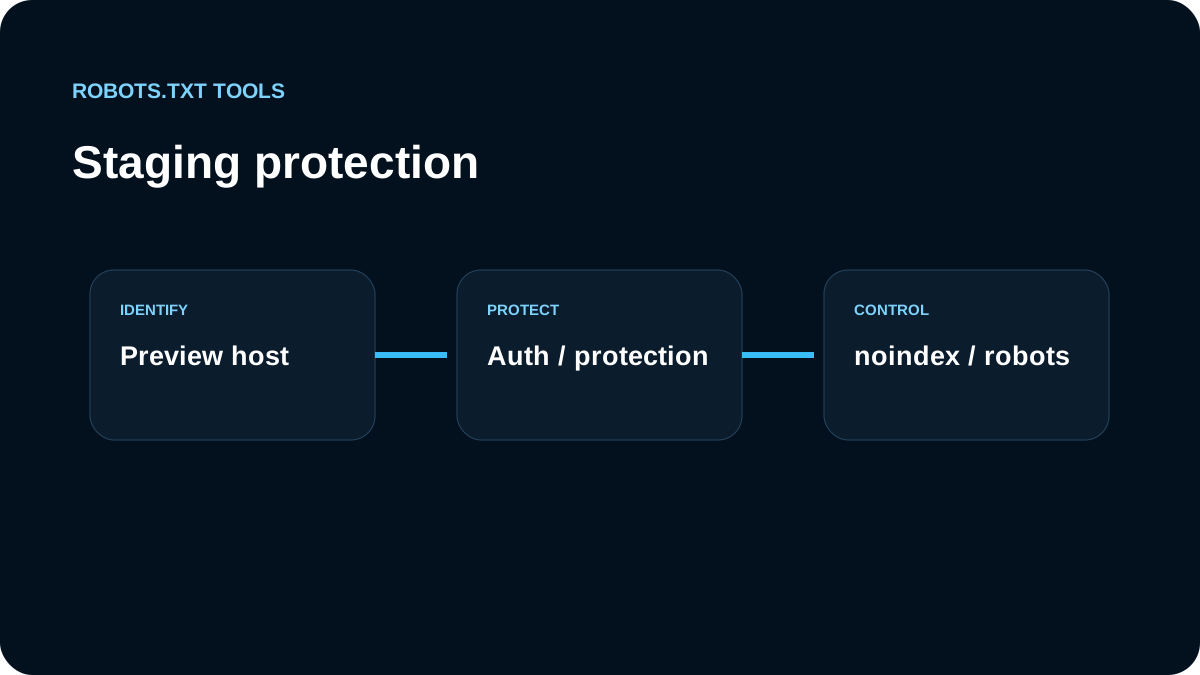
編集チームではステージングの第一層をrobots.txtではなくアクセス制御として設計します。
非公開環境には認証を使います
password、認証、network restrictionなどで実際に保護します。Disallow: /はセキュリティではありません。
公開previewにはnoindexを検討します
レビュー用に公開する必要がある場合、crawlerが読める状態でnoindexを返します。
robots.txtは補助層です
User-agent: *
Disallow: /
クロール抑制には使えますが、認証やnoindexの代替にはしません。
stagingと本番を分離します
両hostを確認し、staging sitemapを外し、Disallow: /が本番設定へ昇格しないようにします。
release前にテストします
本番URLをtesterで確認し、公開robots.txtをcheckerで確認します。
公開範囲に合わせて制御を選びます
社内QAやクライアントreview用stagingは認証・network restrictionが第一です。公開previewを閲覧可能なまま検索結果から外したい場合は、crawl可能な状態で noindex を返す方法があります。robots.txtは補助的なcrawl controlでありsecurityではありません。
最も危険なのはstaging用 Disallow: / がproductionへ混入することです。production policyを明示し、release gateで公開ドメインを直接確認します。
古いpreviewも片付けます
本番公開後は不要なpreview hostを停止するか認証を残します。すでにindexされたstagingへ後から Disallow: / を追加するだけでは削除フローになりません。認証、適切なHTTP status、crawl可能なnoindex期間のどれが必要かを判断します。
Stagingの種類ごとに保護方法を変えます
社内だけで使うQA環境や顧客レビュー環境では、robots.txtより先にauthentication、VPN、IP制限など実際のaccess controlを使います。外部サービスとの連携でpublic accessが必要なpreviewは、検索結果に出したくない場合でもcrawlerが noindex を読める状態を保つ必要があります。そこで、public previewではindex controlとcrawl controlを分けて設計します。
production release時は、staging用 Disallow: / が環境変数や共通template経由で本番へ流れ込まないことを確認します。同時にinternal link、canonical、sitemap、Open Graph URLなどにpreview hostが残っていないかも検査します。robots.txtだけが正しくても、他の参照からcrawlerが古いhostを発見する場合があります。
Launch後のpreviewも管理します
不要になったpreviewはpublicのまま放置せず、削除するかauthenticationを維持します。すでに検索結果へ出たstaging URLに後からDisallowだけを追加しても、削除要求にはなりません。URLを残す必要があるか、適切なHTTP statusへ変えるか、crawl可能な状態でnoindexを処理させるかを目的別に決めます。
Preview URLの発見経路も閉じます
stagingを認証で守っていても、production側のHTML、sitemap、canonical、analytics、issue tracker、共有documentなどにpreview URLが残ると、crawlerや外部ユーザーが存在を発見できます。release時にはrobots.txtだけでなく、生成されたHTMLやsitemapからpreview host文字列を検索し、不要な参照を削除します。
また、複数のpreview providerを使うprojectでは、custom staging domainだけでなくprovider固有の一時domainも確認します。一方だけに Disallow: / を置いても、もう一方がpublicなら目的を達成できません。利用終了後はhostそのものを無効化する方が、永続的なcrawler ruleを保守するより安全です。