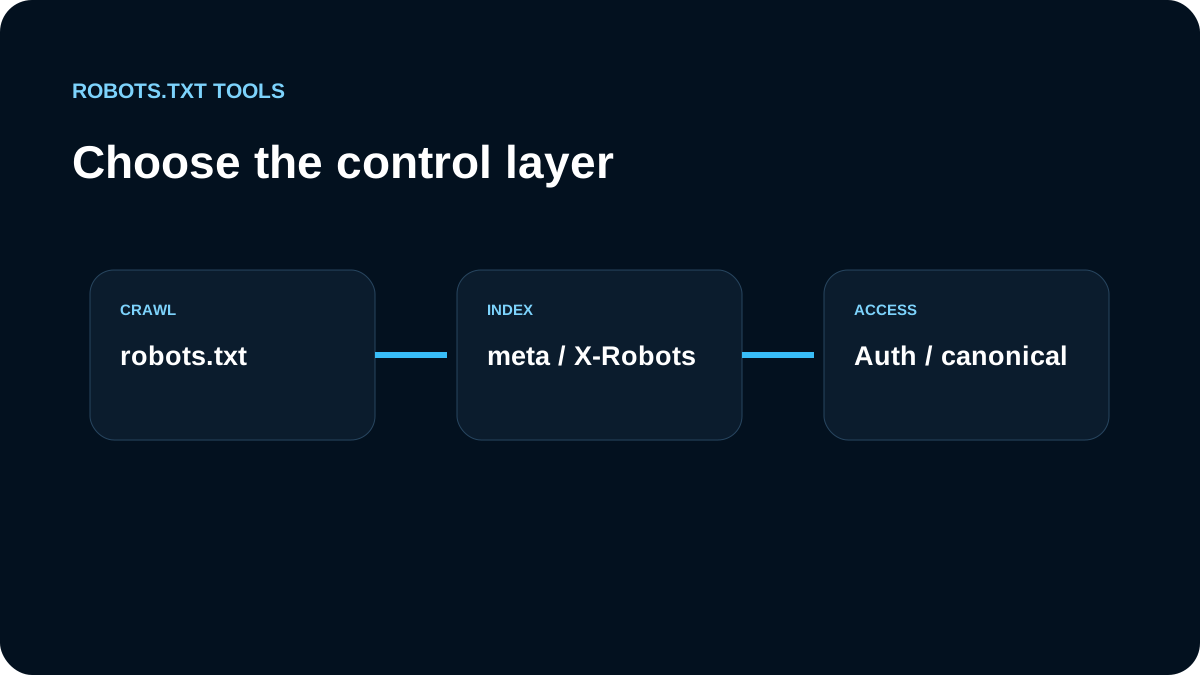
編集チームでは目的から選びます。robots.txtはクロール、noindexはインデックス、canonicalは重複統合、redirectは移転、認証は非公開アクセスのための仕組みです。
robots.txtはクロール制御です
Disallowを検索結果からの削除命令として扱いません。
meta robotsは取得できる必要があります
<meta name="robots" content="noindex">
robots.txtで同じURLをブロックすると、crawlerがnoindexを読めない場合があります。
X-Robots-TagはHTTPヘッダーで使えます
X-Robots-Tag: noindex
PDFなどHTML以外にも利用できます。
canonicalはセキュリティではありません
canonicalはシグナル統合用です。非公開情報には認証や認可を使います。
判断後に本番を確認します
非公開→認証、公開だが検索除外→noindex/X-Robots-Tag、重複→canonical/redirect、クロール浪費→robots.txtを検討し、最後にcheckerで確認します。
制御ごとに役割が違います
Disallow はcrawl、noindex はcrawlerがページを読める場合のindex除外、X-Robots-Tag はPDFなど非HTML、canonicalは重複統合、認証は非公開コンテンツの保護です。これらを「念のため全部付ける」ものとして扱いません。
robots.txtでblockしたページに noindex も置くと、crawlerがそのnoindexを読めないことがあります。公開URLを検索結果から外したいならcrawl可能な状態でindex directiveを返します。機密情報なら認証・認可を使います。
症状から選びます
目的がcrawl削減、検索結果からの除外、重複統合、URL移行、privacyのどれかを先に確認します。主となる制御を一つ選び、必要な場合だけ補助的な制御を追加し、本番のrobots.txt、HTML/header、最終URLをまとめて検証します。
目的を一文で定義してから制御を選びます
「検索に出したくない」という要望だけでは、robots.txtを変更する根拠として不十分です。crawl回数を減らしたいのか、検索結果からURLを外したいのか、重複URLを統合したいのか、ユーザーにも見せたくないのかで手段が変わります。crawl削減ならrobots.txt、index除外ならnoindex、重複統合ならcanonicalやredirect、非公開ならauthenticationを第一候補にします。
PDFやfeedなどHTMLのheadを持たないresourceでは、HTTPの X-Robots-Tag が扱いやすい場合があります。設定ファイルだけを見ず、最終200 responseにheaderが残っているかを確認します。CDNやstorage layerでheaderが消えるケースもあるためです。
組み合わせをproductionで確認します
robots.txtとnoindexを同時に使う場合は特に注意します。Disallowによってcrawlerがpageを取得できなければ、noindexを読めない可能性があります。変更後は対象URLのcrawl判定、HTMLまたはHTTP header、canonical、status codeを一緒に記録し、目的とsignalが矛盾していないかを確認します。privacyが目的ならcrawler directiveではなくアクセス制御を検証します。
RemovalとPrivacyを混同しません
検索結果から消したいだけのURLと、誰にも見せたくないURLでは要件が違います。前者はcrawlerがnoindexを読めることが重要で、後者は認証が必要です。robots.txtはpublic fileなので、秘密のpath名や機密resourceを保護する仕組みとしては使いません。