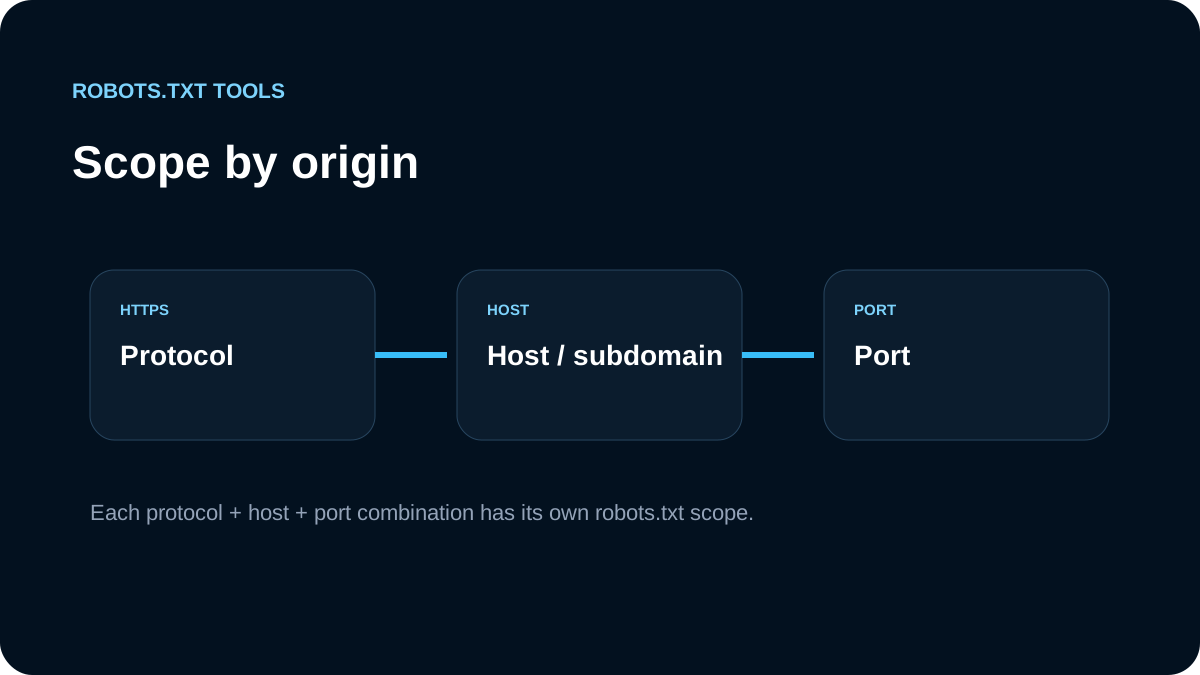
編集チームでは、ルールが正しいのに効かない場合、まず適用範囲を確認します。robots.txtはprotocol、host、ポートで決まるorigin単位です。
originを分けて確認します
https://example.com/robots.txt
https://shop.example.com/robots.txt
http://example.com/robots.txt
https://example.com:8443/robots.txt
これらに自動継承はありません。
公開hostを一覧化します
本番、www、shop、docs、preview、stagingを別々に開きます。古いファイルや404、異なるプラットフォームが見つかることがあります。
配信元を確認します
framework、CMS、CDN、reverse proxyのどこが公開レスポンスを生成しているかを確定してから変更します。
正しいhostでURLをテストします
shopのURLはshop側のポリシーでテストします。testerで勝つルールを確認し、checkerで公開ファイルを確認します。
stagingは認証で守ります
Disallow: /はセキュリティではありません。非公開環境には認証やアクセス制御を使い、公開previewではnoindexも検討します。
robots.txtの範囲はOrigin単位です
robots.txtはプロトコル・ホスト・ポートの組み合わせに属します。https://example.com/robots.txt は shop.example.com、www.example.com、HTTP、別ポートへ自動継承されません。公開されているOriginを一覧化し、それぞれの /robots.txt を取得します。
CDN移行、www/apex切り替え、EC・ドキュメント・マーケティングを別サービスで運用する構成では特に重要です。メインドメインの正しいファイルだけでは、別サブドメインの古いルールは直りません。
Redirectでポリシーは統合されません
wwwからapexへredirectしていても、robots.txtの取得経路は個別に確認します。アプリ、CDN、CMS、外部プラットフォームのどれが公開レスポンスを所有しているかを特定し、その層を修正します。
Origin単位で管理表を作ります
複数hostを持つサイトでは、apex、www、shop、docs、support、stagingなどを一覧にし、それぞれについてprotocol、port、公開担当システム、robots.txtの所有レイヤーを記録します。同じ会社のドメインでもrobots policyは自動共有されません。たとえばメインサイトがNext.js、shopがSaaS型EC、docsが別CDNなら、三つのrobots.txtは別のデプロイ経路で管理される可能性があります。
wwwからapexへ301 redirectしている場合も、homepageの最終URLだけを見て判断しません。crawlerが要求する /robots.txt のredirect chainを直接確認し、どのoriginが最初に応答したかを記録します。HTTPからHTTPSへの移行や一時的なproxy構成でも同じです。ユーザー向けページが正常に転送されていても、robots.txtだけ古い経路に残ることがあります。
移行時の失敗を防ぐチェック
新しいhostへ切り替える前後で、各originのrobots.txt、sitemap、canonical、主要redirectを同時に確認します。不要になったsubdomainがまだpublicなら、検索crawlerがそこへ到達する経路も残っていないかを確認します。問題が見つかったら、メインドメイン側に例外を追加するのではなく、そのoriginを実際に配信しているCDN、CMS、application側で修正します。