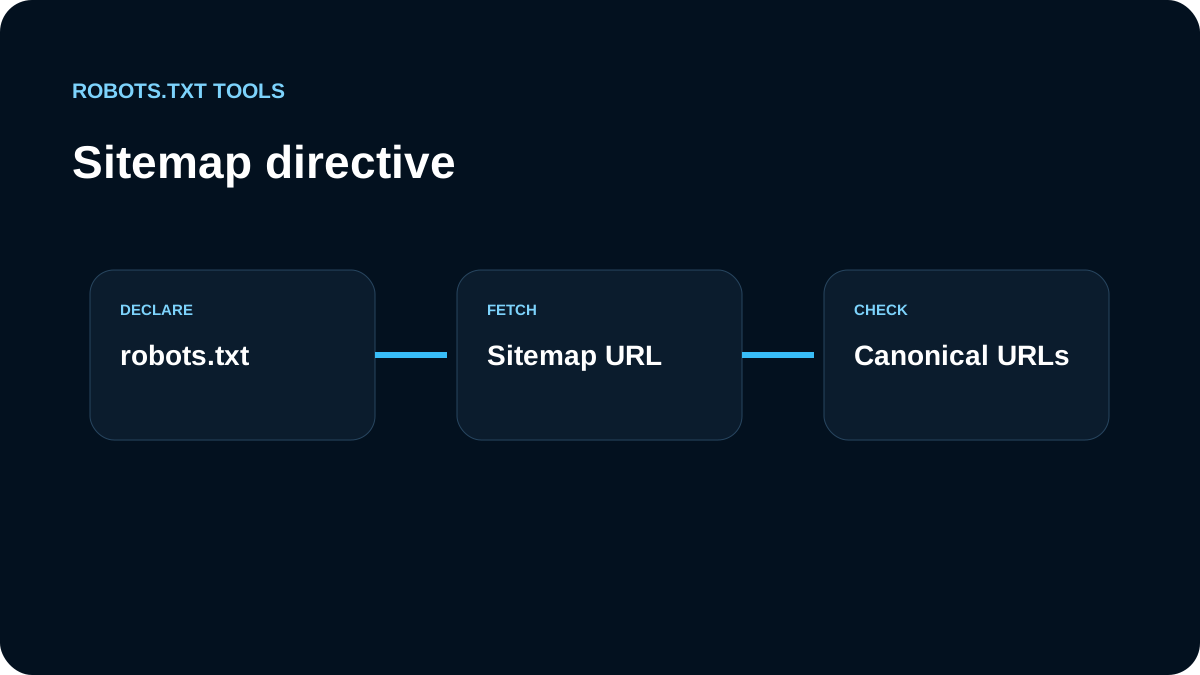
編集チームでは、Sitemap:をAllowやDisallowとは別の発見シグナルとして扱います。
先にSitemap本体を確認します
XMLのHTTPステータス、HTTPS、正規ホスト、掲載URLを確認してから絶対URLを記述します。
Sitemap: https://example.com/sitemap.xml
相対URLだけを書く運用は避けます。
複数ファイルとindexを整理します
複数のSitemap:行は利用できます。ただし安定したsitemap indexがある場合は、子ファイルをrobots.txtにも重複管理せずindexを優先します。
Sitemap: https://example.com/sitemap-index.xml
ホストごとの範囲を分けて確認します
ルートドメインとサブドメインは別のrobots.txt範囲です。複数ホストを使う構成では、各originを確認し、必要ならサブドメインのガイドも参照します。
Search Consoleも併用します
robots.txt内の参照は発見を助けますが、サイトマップ品質を保証しません。redirect、noindex、非canonical URLが含まれていないかも確認します。
本番で最終確認します
本番/robots.txt、各Sitemap URL、XML内の代表URLを開き、checkerとvalidatorで公開状態をチェックします。
Sitemap行でできること・できないこと
Sitemap: はXMLの発見を助けるための参照であり、記載URLを自動的にインデックス可能にしたり、Disallow を上書きしたりするものではありません。プロトコルとホストを含む絶対URLを使い、本番ドメインであることを確認します。安定したsitemap indexが子ファイルを管理している場合は、robots.txtにすべてを重複記載しません。
別ホストのsitemapも技術的には可能ですが、誰が生成し、どのプロパティを表しているかを確認します。移行時はredirect、canonical、sitemap、Search Consoleが同じ本番ホストを指す必要があります。
公開前に確認する項目
参照XMLのHTTPステータス、canonical host、公開URL、indexableページのサンプルを確認します。robots.txtのSitemap行は発見経路にすぎず、redirectやnoindex、非canonical URLを含むXMLそのものの品質問題は解決しません。
Sitemap参照を変更する前に確認すること
Sitemap行を直す場面では、単にURL文字列だけを見ません。まずXML自体を開き、200で取得できること、最終的なホストが本番ドメインであること、主要URLがredirectやnoindexになっていないことを確認します。複数のsitemapを運用している場合は、robots.txtにすべての子ファイルを列挙するのか、sitemap indexだけを参照するのかを決めます。両方を重複して管理すると、移行後に片方だけ古いhostを残す事故が起きやすくなります。
別ドメインやCDN上のsitemapを使う構成では、そのXMLを誰が生成し、どのサイトのURLを含むのかも確認します。技術的に取得できることと、SEO上正しいinventoryであることは別問題です。ドメイン移行時はredirect、canonical、hreflang、sitemap、Search Consoleのプロパティが同じ移行先を示しているかをまとめて見ます。
本番での確認手順
公開後はrobots.txtを直接取得し、記載されたSitemap URLを一つずつ開きます。XMLから代表URLを選び、canonical host、HTTP status、indexing directiveを確認します。検索エンジンへの送信が成功していても、XML内容が古ければ発見効率は改善しません。robots.txtのSitemap行は発見の入口であり、XMLの品質保証そのものではない、という前提で運用します。