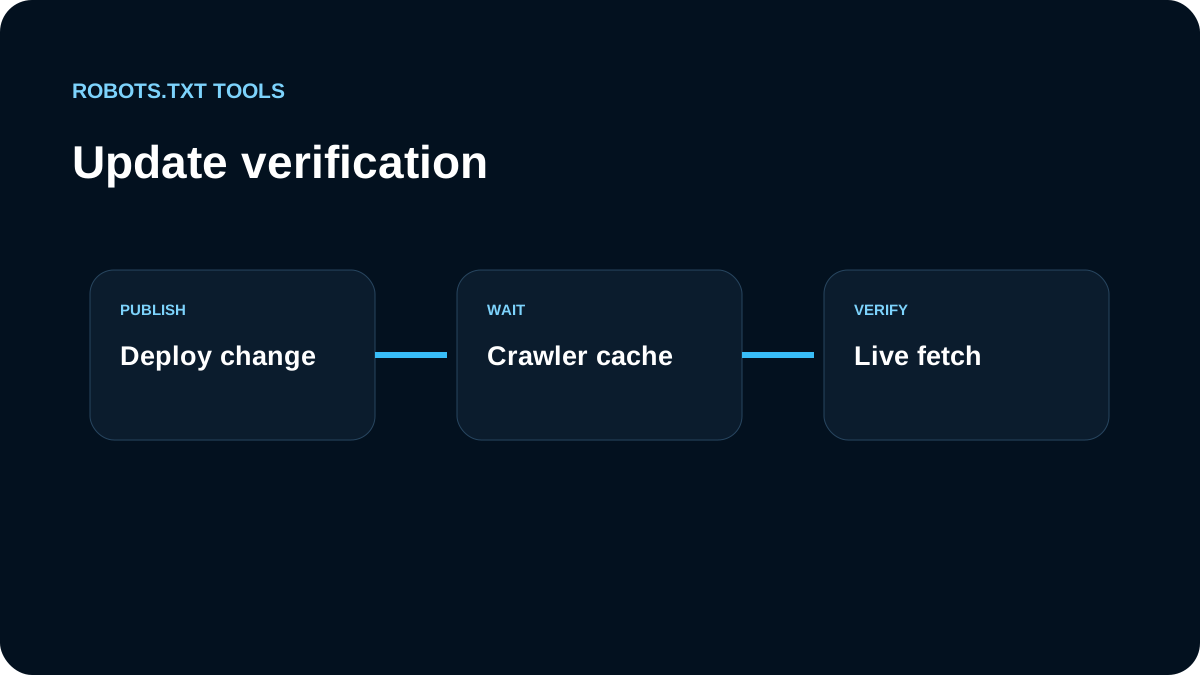
変更が効かないとき、編集チームではリポジトリ、本番レスポンス、crawlerキャッシュを分けて確認します。
まず本番を取得します
正しいhostのステータス、最終URL、本文を確認します。古いCDNオブジェクトや失敗したデプロイをGoogleのキャッシュと混同しません。
24時間前後のキャッシュを考慮します
Googleはrobots.txtを通常およそ24時間キャッシュすると説明しています。状況により差があるため、数分ごとの再編集は避けます。
hostごとに確認します
apex、www、subdomainで公開ファイルが異なる場合があります。build、CDN、proxy、dynamic生成も追います。
HTTPエラーを先に分けます
5xxや429と、200で古い本文が返る状態は別問題です。
live状態を確認します
checkerで公開ファイル、testerでURL判定を確認し、必要に応じてSearch Consoleやログを使います。
24時間前後を診断の基準にします
Googleはrobots.txtを通常およそ 24時間 cacheすると説明しており、timeoutや 5xx で再取得できない場合は古い内容が長く使われることがあります。Cache-Controlも影響し得ます。そのため本番ファイルが新しくてもcrawler挙動が即時に変わるとは限りません。
checkerでも古い本文ならdeploy/CDNを確認します。本番レスポンスは新しいのにcrawlerだけ古い挙動なら、通常のcrawler cacheが候補です。server errorがある場合はrule interpretationより可用性を先に直します。
Before/Afterを保存します
重要変更では旧本文、deploy時刻、status、final URL、headers、新本文を記録します。これによりcrawler cache、edge cache、rollbackを区別でき、伝播中に不要な再編集を重ねずに済みます。
変更が見えない原因を三層に分けます
robots.txtを更新したのに結果が変わらない場合、source repository、公開配信、crawler cacheを分けて確認します。まずproductionの /robots.txt を直接取得し、status、final URL、body、Cache-Controlを保存します。ここで古い内容が返るなら、Googleのcacheではなくdeploy、CDN、proxy、route ownershipの問題です。公開bodyが新しい場合に初めてcrawler側の再取得タイミングを疑います。
Googleは通常およそ24時間のcacheを説明していますが、timeoutや5xxでrefreshできないと古い内容が長く使われることがあります。したがってcrawlerが更新しないからといって数分おきにfileを書き換えるのは逆効果です。server logがある場合は、Googlebotなど対象crawlerがいつ /robots.txt を取得したかも確認します。
変更履歴を残します
重要なpolicy変更では、旧body、新body、deploy時刻、HTTP headers、対象hostを一つの記録に残します。wwwとapex、subdomain、previewで別versionが出ていないかも確認します。このbefore/after evidenceがあれば、crawler cache、edge cache、rollback、別host参照を切り分けやすくなり、推測で次の変更を重ねずに済みます。
Hostごとの差も確認します
同じサイトでもwww、apex、subdomainで別cacheや別robots.txtが配信されることがあります。reportに出ているURLのoriginをそのまま取得し、別hostの正常なresponseで判断しないようにします。