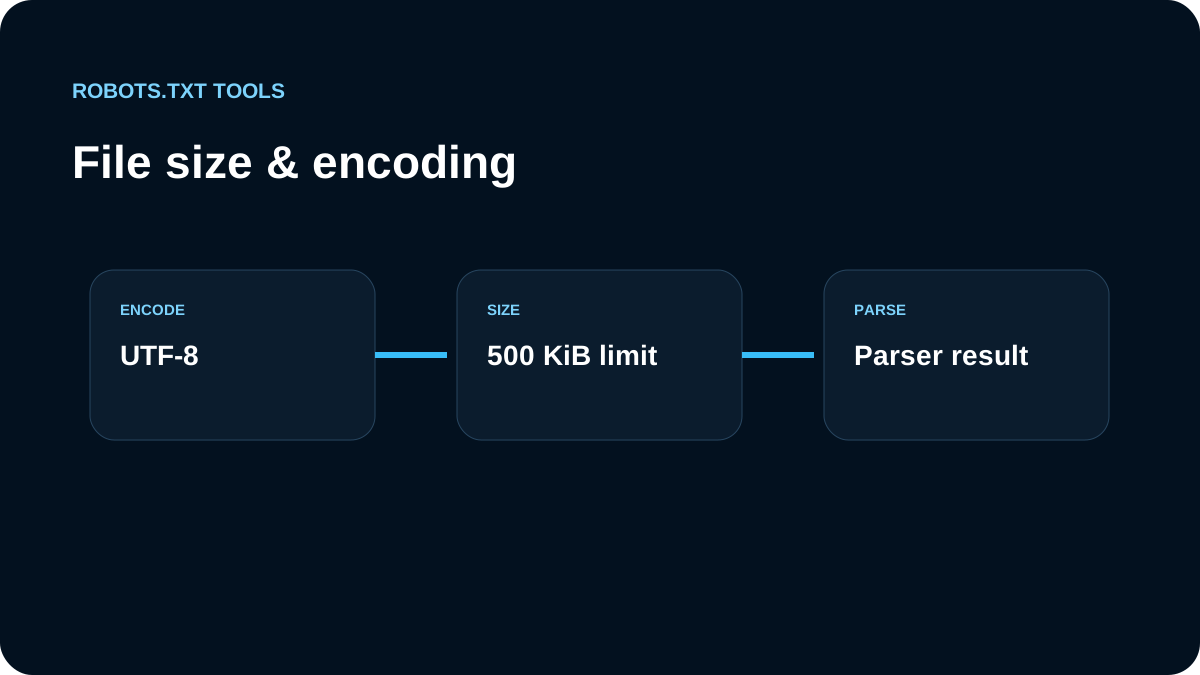
編集チームではソースではなく本番レスポンスのサイズを測ります。Googleは500 KiBのrobots.txt上限を説明しています。
UTF-8を前提に確認します
古い文字コードや不正なbyteを避けます。非ASCIIのパスではURLエスケープも合わせて確認します。
重複ルールを減らします
巨大ファイルではURL単位の列挙、生成コメント、重複groupを探します。安定したパスルールの方が保守しやすくなります。
簡略化後に必ず検証します
短いwildcardが広すぎる可能性があります。validatorとtesterで確認します。
本番配信をチェックします
CDN、redirect、dynamic生成でソースと別の内容が出ることがあります。checkerでHTTP状態と公開本文を確認します。
500 KiBを超えると後半ルールが無視される可能性があります
Googleはrobots.txtを約 500 KiB まで処理し、それ以降を無視する場合があります。そのため上限ぎりぎりを目標にせず、コメントや新しいcrawler groupが追加されても重要ルールが処理範囲外へ押し出されない余裕を持たせます。
Encoding問題はmatching問題に見えることがあります
エディタ表示だけでなく、実際に配信されるUTF-8 bytesを確認します。BOM、置換文字、非ASCII path、大文字小文字、percent-encoded表現を確認し、HTMLエラーページがテキストとして誤配信されていないかも見ます。
ファイルが巨大なら、重複group、URL単位の列挙、巨大なbot listを先に減らします。短く説明可能なルールの方が監査しやすく、サイズ制限にも強くなります。
サイズ上限より十分小さく保ちます
500 KiBは「目標サイズ」ではなく処理上限として扱います。生成ツールやbot listによってファイルが継続的に増える構成では、現在のサイズだけでなく増加理由を確認します。同じUser-agent groupが何度も重複していないか、URLを一件ずつ列挙していないか、古いcampaignや一時pathのruleが残っていないかを整理します。重要なAllow/Disallowがファイル後半に追いやられる状態は避けます。
encoding確認では、editor上で読めることだけでは不十分です。実際のHTTP response bodyを取得し、UTF-8として正しく解釈できるか、BOMやreplacement characterが混入していないか、非ASCII pathとpercent-encoded URLが意図どおりmatchするかを試します。大小文字を区別するpathや、生成時に二重encodeされた文字列もテスト対象です。
配信レイヤーまで検証します
repositoryのsourceが正しくても、CDN、reverse proxy、serverless route、CMSが別内容を返すことがあります。公開 /robots.txt のstatus、content-type、byte size、bodyを保存し、validatorとcheckerで確認します。異常に大きなfileを見つけた場合は末尾だけ削るのではなく、どのgeneratorや設定が重複を作っているかを直してから再生成します。
自動生成ファイルは差分監視します
CMSやbuild stepがrobots.txtを生成する場合、releaseごとのbyte sizeとrule countを記録します。急増したときは、新しいbot listや重複groupを疑います。source codeだけでなく公開responseの差分を見ることで、意図しないgenerator変更を早く検出できます。