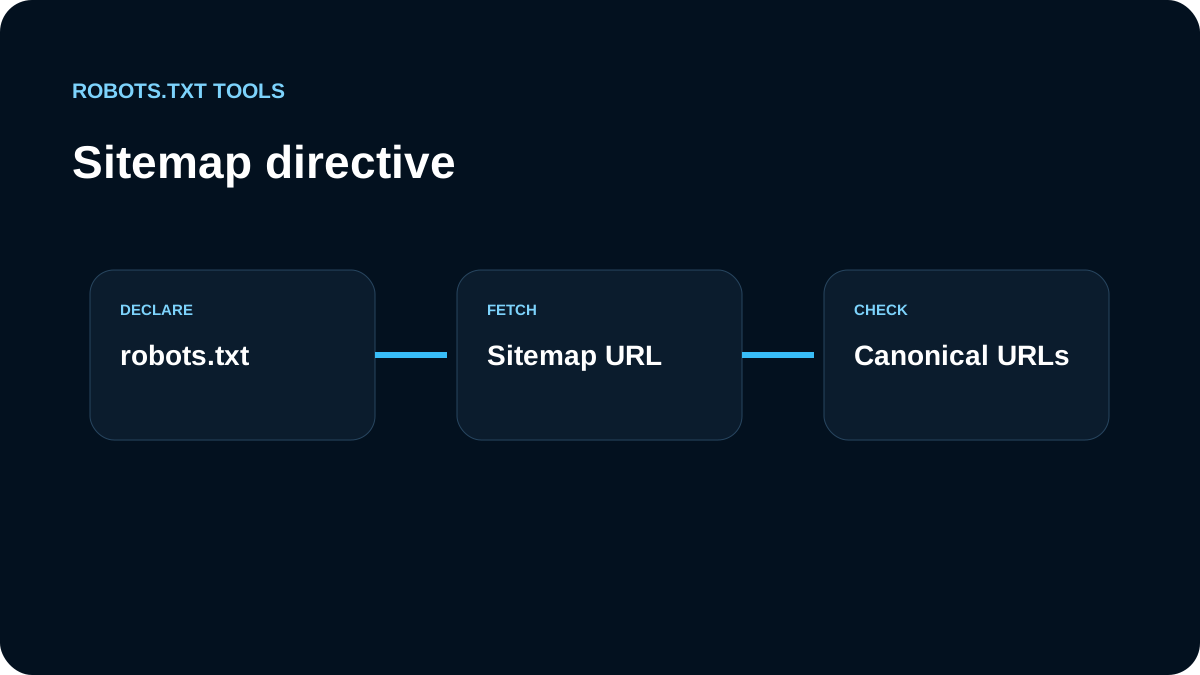
Noi trattiamo Sitemap: come riferimento di discovery, non come regola Allow o Disallow.
Controlliamo prima la sitemap
Apriamo l’XML, verifichiamo status HTTP, HTTPS, host canonical e URL presenti. Poi usiamo un URL assoluto:
Sitemap: https://example.com/sitemap.xml
Sitemap multiple o un index
Più righe Sitemap: sono valide. Se esiste un sitemap index stabile, preferiamo usarlo per evitare di mantenere due inventari.
Sitemap: https://example.com/sitemap-index.xml
Separiamo gli host
Il robots.txt del dominio principale non controlla automaticamente i sottodomini. In un’architettura multi-host verifichiamo ogni origin e usiamo la guida ai sottodomini quando il problema è lo scope.
Search Console completa il controllo
La dichiarazione aiuta la scoperta, ma non garantisce la qualità della sitemap. Verifichiamo anche redirect, noindex e URL non canonical.
Controlliamo la production
Dopo la pubblicazione apriamo /robots.txt, ogni sitemap e un campione di URL, quindi usiamo checker e validator.
Cosa può fare una riga Sitemap — e cosa non può fare
Sitemap: aiuta i crawler a scoprire l’XML, ma non rende automaticamente indicizzabili gli URL e non annulla una regola Disallow. Usiamo un URL assoluto con protocollo e host, verifichiamo il dominio di produzione e preferiamo un sitemap index stabile quando gestisce già i file secondari.
Un sitemap su un altro host può essere valido, ma controlliamo ownership e contenuto. Durante una migrazione redirect, canonical, sitemap e Search Console devono indicare la stessa architettura; una riga tecnicamente corretta può altrimenti continuare a promuovere un host vecchio.
Controlli prima della pubblicazione
Apriamo ogni sitemap, verifichiamo stato HTTP, host canonico, URL pubblici e un campione di pagine realmente indicizzabili. robots.txt è solo un canale di discovery: non corregge un XML con redirect, noindex o URL non canonici.