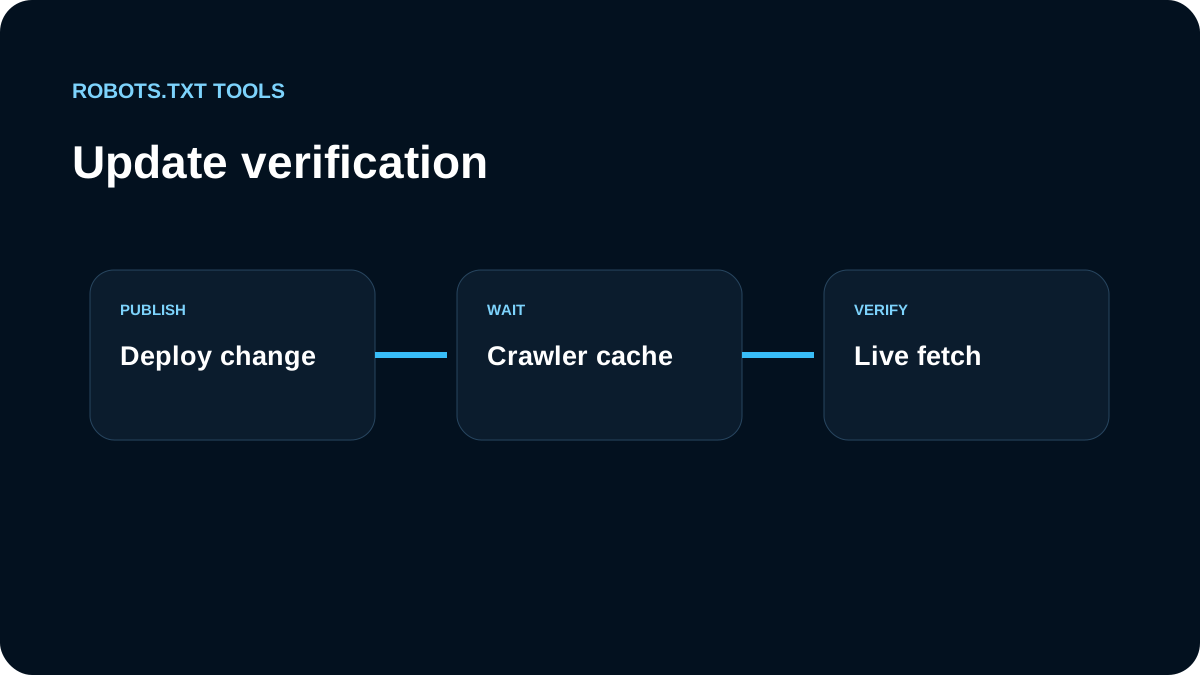
Quando una modifica sembra ignorata, noi separiamo repository, risposta pubblica e cache del crawler.
Controlliamo prima la production
Recuperiamo l’host corretto e annotiamo status, URL finale e body. Un vecchio oggetto CDN o un deployment fallito non è cache di Google.
Consideriamo il normale intervallo di cache
Google documenta che robots.txt viene in genere memorizzato per circa 24 ore, con possibili variazioni.
Verifichiamo ogni origin
Apex, www e sottodomini possono servire versioni diverse. Controlliamo anche build, CDN, reverse proxy e generazione dinamica.
Gli errori HTTP cambiano la diagnosi
Un 5xx o 429 è diverso da un 200 con contenuto vecchio.
Verifichiamo il file live
Il checker conferma la risposta corrente; il tester verifica URL specifiche. Search Console e log possono completare il quadro.
La finestra di cache è il nostro riferimento
Google indica che robots.txt viene normalmente memorizzato in cache per circa 24 ore; la versione precedente può durare più a lungo se il refresh fallisce per timeout o 5xx. Anche Cache-Control può incidere. Un file corretto in produzione quindi non implica un cambio immediato del comportamento del crawler.
Se il checker vede ancora il vecchio body, controlliamo deploy e CDN. Se la risposta live è nuova ma il crawler sembra usare regole vecchie, la cache del crawler è plausibile. In presenza di errori server, correggiamo prima l’affidabilità.
Conserviamo evidenza prima/dopo
Per modifiche rischiose salviamo body precedente, ora del deploy, status, URL finale, header e nuovo body. Questo aiuta a distinguere cache crawler, cache edge e rollback senza pubblicare una seconda modifica che confonde la timeline.