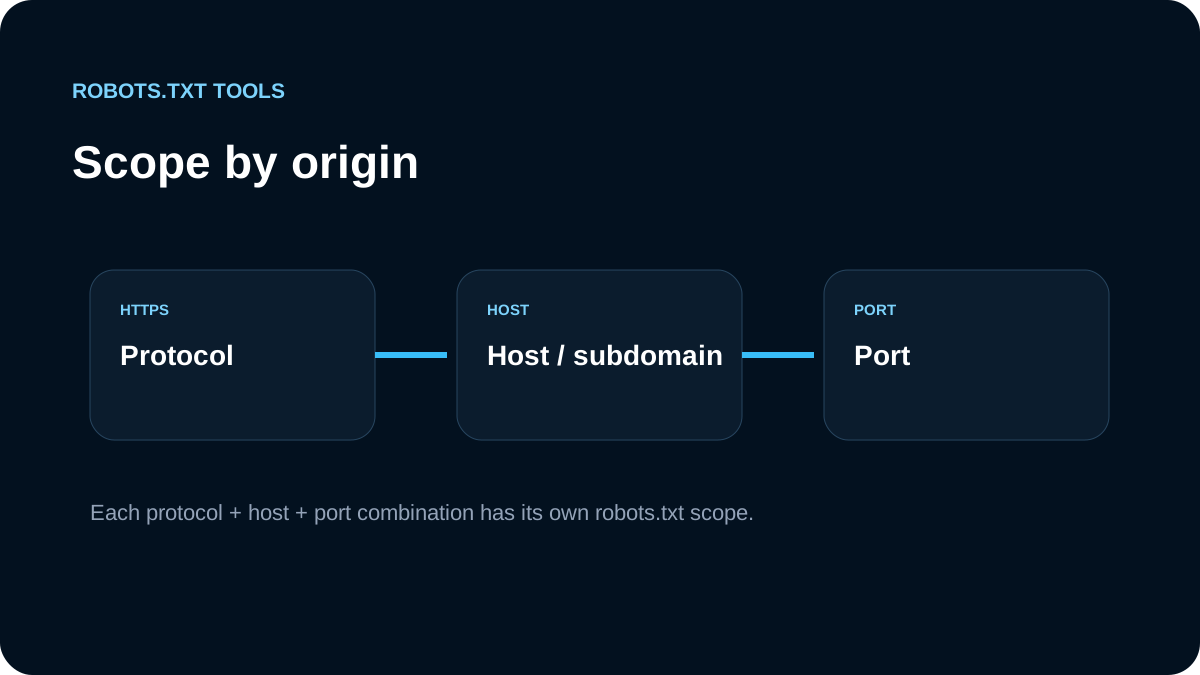
Quando una regola sembra corretta ma non funziona, noi controlliamo lo scope prima della sintassi. Robots.txt vale per una specifica origin composta da protocollo, host e porta.
Separiamo ogni origin
https://example.com/robots.txt
https://shop.example.com/robots.txt
http://example.com/robots.txt
https://example.com:8443/robots.txt
Non esiste ereditarietà automatica tra queste origini.
Creiamo un inventario degli host
Production, www, shop, docs, preview e staging vengono controllati separatamente. Questo spesso evidenzia file vecchi, 404 o piattaforme diverse.
Identifichiamo chi pubblica la risposta
Framework, CMS, CDN o reverse proxy possono possedere /robots.txt. Modifichiamo il livello che serve davvero il file pubblico.
Testiamo l’URL sull’host corretto
Una URL dello shop viene verificata contro la policy dello shop. Il tester mostra la regola vincente e il checker conferma il file live.
Lo staging richiede sicurezza reale
Per contenuti privati usiamo autenticazione o access control. Disallow: / non è sicurezza. Per preview pubblici valutiamo anche noindex.
Lo scope è per origine
robots.txt appartiene alla combinazione protocollo, host e porta. Il file di https://example.com non controlla automaticamente shop.example.com, www.example.com, HTTP o un’altra porta. Inventariamo quindi tutte le origini pubbliche e recuperiamo il loro /robots.txt.
Questo evita di correggere il dominio principale mentre un sottodominio continua a servire regole vecchie tramite un altro CMS, CDN o servizio.
I redirect non fondono le policy
Anche se www redirige verso il dominio principale, ispezioniamo la catena reale di /robots.txt. Identifichiamo il livello proprietario della risposta — applicazione, CDN, CMS o piattaforma — e modifichiamo quello. Così evitiamo regole in un file che non controlla l’origine problematica.