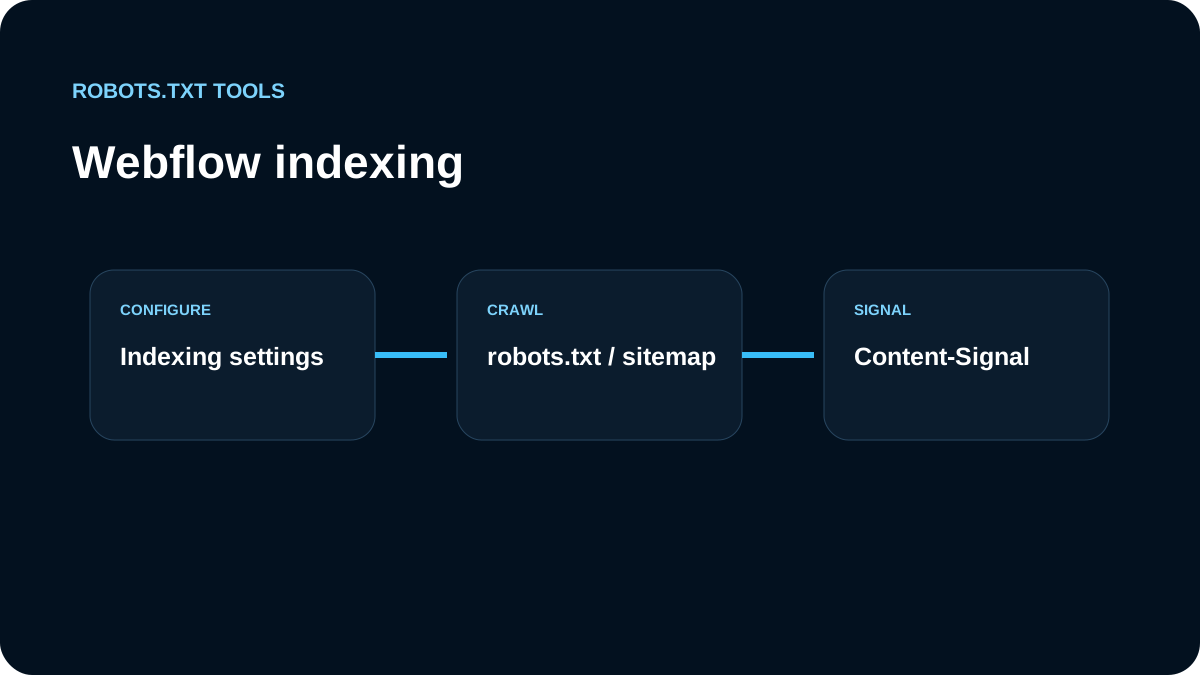
Dans Webflow, nous intégrons robots.txt au processus de publication. Les réglages se trouvent dans Site settings → SEO → Indexing.
Nous vérifions la production avant modification
Nous ouvrons /robots.txt et cherchons blocages trop larges, mauvais domaine et lignes Sitemap: dupliquées.
Nous tenons compte du sitemap automatique
Avant d’ajouter une ligne, nous vérifions si Webflow l’a déjà créée. Les architectures reverse proxy ou multi-site demandent aussi de vérifier l’option documentée de remplacement.
Sauvegarder ne suffit pas : nous publions
Nous modifions, sauvegardons, faisons publish, puis rechargeons la réponse. Si elle reste ancienne, nous examinons cache et routage de domaine.
Content-Signal reste une autre couche
Content-Signal concerne des préférences d’usage IA ; robots.txt concerne le crawl. Nous gardons ces mécanismes distincts.
Nous testons avant release
Nous utilisons le tester et le validator. Les previews privés utilisent authentification.