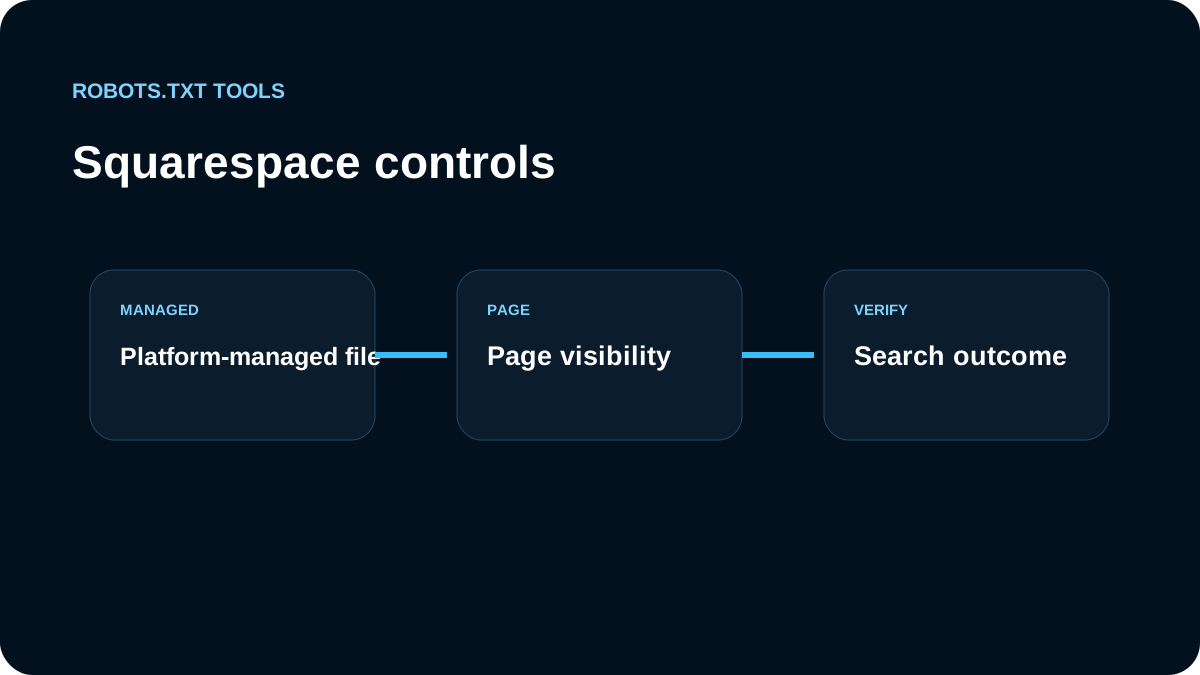
Squarespace gère une grande partie de robots.txt. Nous utilisons donc les contrôles supportés plutôt qu’un workflow de fichier raw inexistant.
Nous reconnaissons le traitement de /search
Une exclusion /search peut être un comportement normal de la plateforme.
Crawlers gère la visibilité globale
Pour une décision à l’échelle du site, nous utilisons Crawlers et vérifions ensuite la sortie publiée.
noindex est plus précis par page
Une URL publique individuelle utilise le contrôle noindex/indexation. Le privé reste derrière mot de passe ou contrôle d’accès.
Le sitemap est automatique
Nous ouvrons le sitemap généré et contrôlons les URL canoniques, sans essayer de maintenir manuellement le XML.
Nous contrôlons la sortie réelle
Nous vérifions /robots.txt, /sitemap.xml, le checker et le tester.