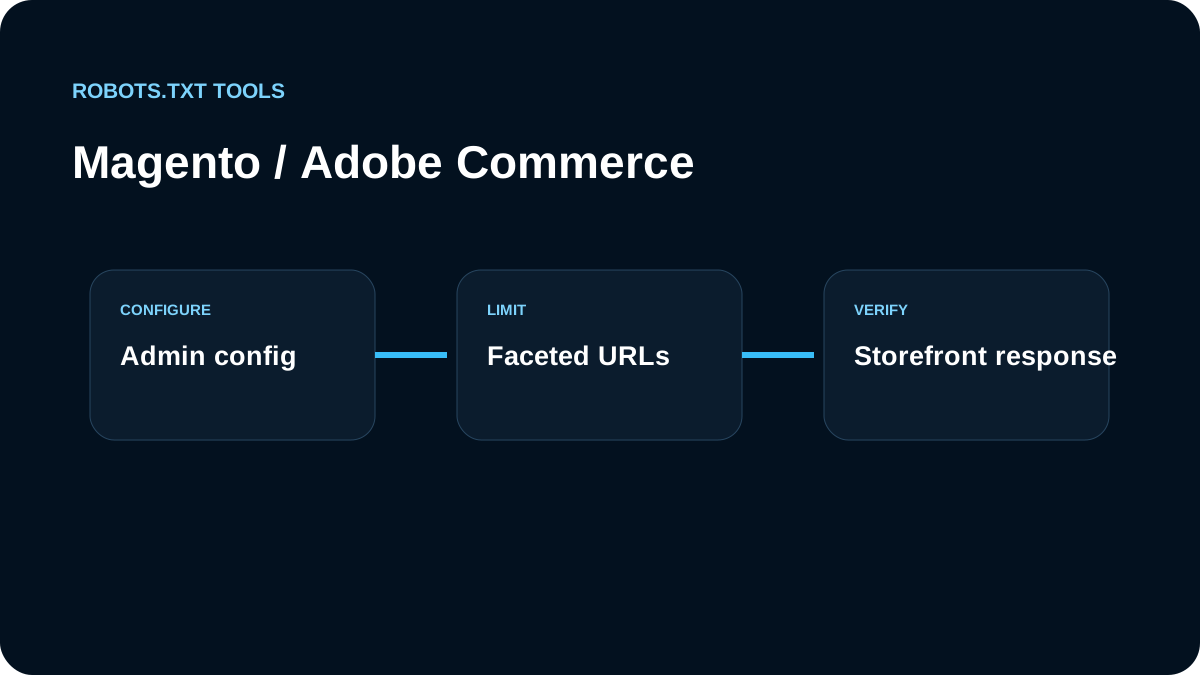
No Magento/Adobe Commerce nós identificamos primeiro qual camada serve a loja pública.
Revisamos Content → Design → Configuration
No store view correto procuramos Search Engine Robots e depois verificamos /robots.txt no domínio real.
Default Robots é outra camada
Default Robots cuida de diretivas de indexação de páginas; não é sinônimo do arquivo de crawling.
Ecommerce exige teste real
Busca interna, conta, carrinho e facetas variam por loja. Não copiamos blocklists genéricos e usamos a guia de parâmetros.
Cloud muda o ambiente
No Adobe Commerce Cloud revisamos separação entre staging e produção, sitemap e controles de indexação.
PWA/headless pode ser o dono
Se PWA, headless frontend ou CDN entrega o host público, esse sistema pode controlar robots.txt. Nós verificamos Cloud, PWA/headless e resposta pública com o checker.