Con Magento/Adobe Commerce, noi identifichiamo prima il livello che serve lo storefront pubblico.
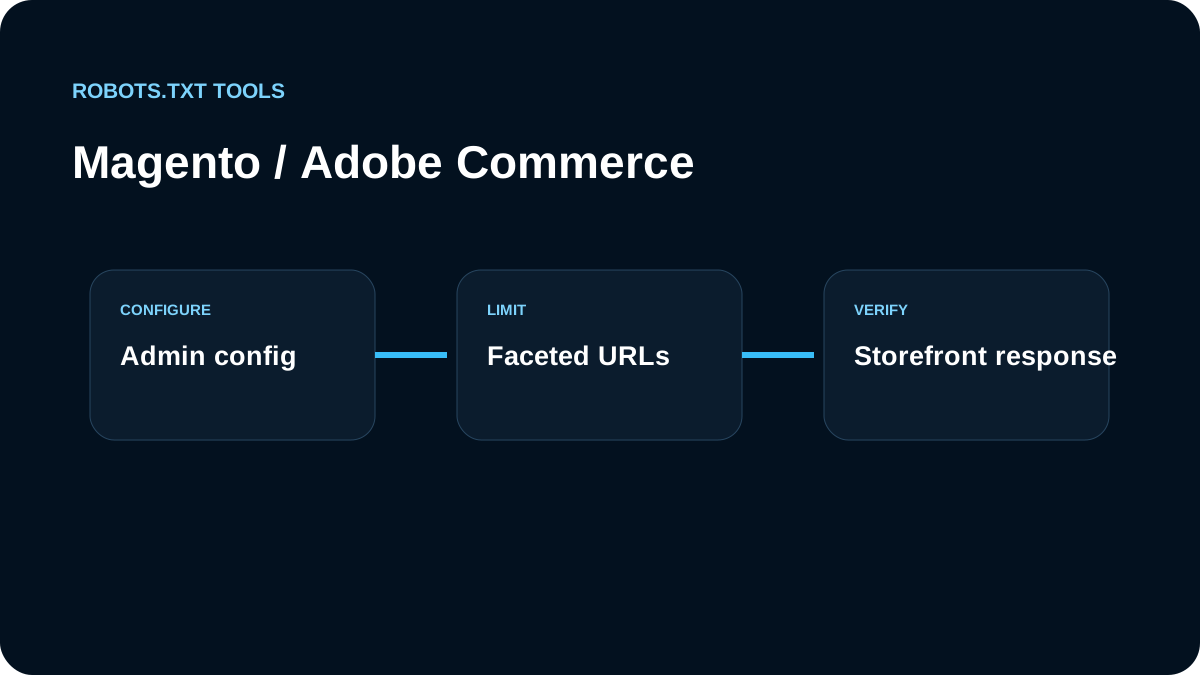
Partiamo da Content → Design → Configuration
Nello store view corretto controlliamo Search Engine Robots, poi confrontiamo /robots.txt sul dominio reale.
Default Robots è un controllo diverso
Default Robots gestisce direttive di indicizzazione delle pagine; non è il file di controllo del crawling.
Ecommerce richiede URL reali
Search, cart, account e facet cambiano tra negozi. Non copiamo blocklist generiche e usiamo la guida ai parametri per le URL faceted.
Cloud cambia il contesto di ambiente
In Adobe Commerce Cloud verifichiamo staging, production, sitemap e controlli di indicizzazione per ambiente.
PWA/headless può spostare l’ownership
Se PWA/headless frontend o CDN serve l’host pubblico, quel livello può possedere /robots.txt. Controlliamo Cloud, PWA/headless e risposta live con il checker.