Per /products?sort=price o /search?q=shoes, noi non partiamo da Disallow: /*?. Prima classifichiamo ordinamento, filtro, facet, tracking, sessione, paginazione e ricerca interna.
Testiamo la query string esatta
User-agent: *
Disallow: /*?sort=
Usiamo il tester con URL che devono essere bloccate e con eccezioni che devono restare accessibili.
Un duplicato non richiede sempre robots.txt
Per tracking, canonical, redirect o una generazione link più pulita possono essere migliori. Se una pagina pubblica non deve entrare nell’indice, valutiamo noindex.
Le faccette richiedono selezione
Alcuni filtri ecommerce hanno valore di ricerca, altre combinazioni generano crawl expansion. Manteniamo gli stati utili e limitiamo quelli senza valore dimostrato.
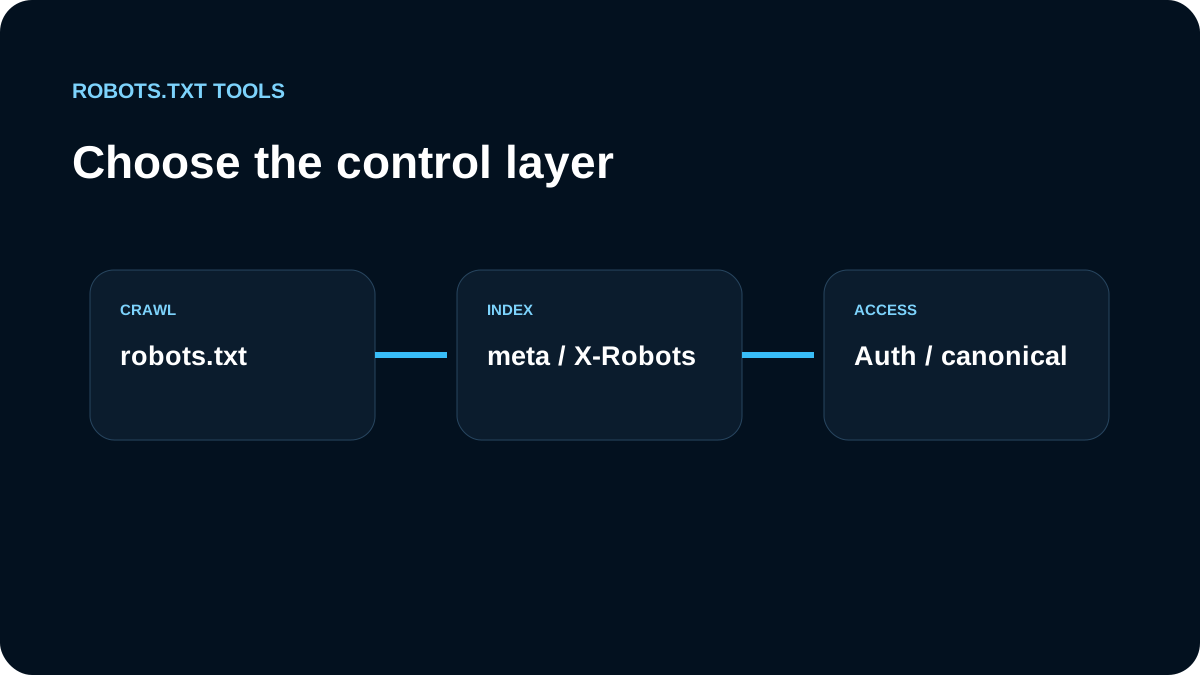
Separiamo scansione e indicizzazione
Robots.txt controlla l’accesso del crawler; noindex controlla l’indicizzazione quando la pagina può essere letta. Vedi robots.txt vs meta robots.
Verifichiamo dopo il deployment
Creiamo una matrice di URL e ripetiamo i test sul file live con il checker.
La navigazione a faccette richiede una scelta esplicita
Google descrive oggi la navigazione a faccette come possibile origine di spazi URL quasi infiniti. Se le combinazioni filtrate non devono apparire in ricerca, limitare il crawl può avere senso. Se devono restare crawlable, manteniamo ordine dei parametri prevedibile, evitiamo combinazioni duplicate o inutili e restituiamo un vero 404 per stati senza risultati.
Tracking, ricerca interna, ordinamento e filtri non sono equivalenti. I parametri campagna spesso si gestiscono meglio con link puliti e canonical; la ricerca interna ha in genere scarso valore di indicizzazione; gli ordinamenti possono creare crawl waste; alcune faccette di categoria, colore o taglia possono invece meritare landing page dedicate.
Riduciamo anche la generazione degli URL
robots.txt non elimina i link. Controlliamo filtri, navigazione, paginazione, JavaScript e sitemap. Se l’applicazione può smettere di produrre combinazioni inutili, questa soluzione è più mantenibile di una lista crescente di wildcard.