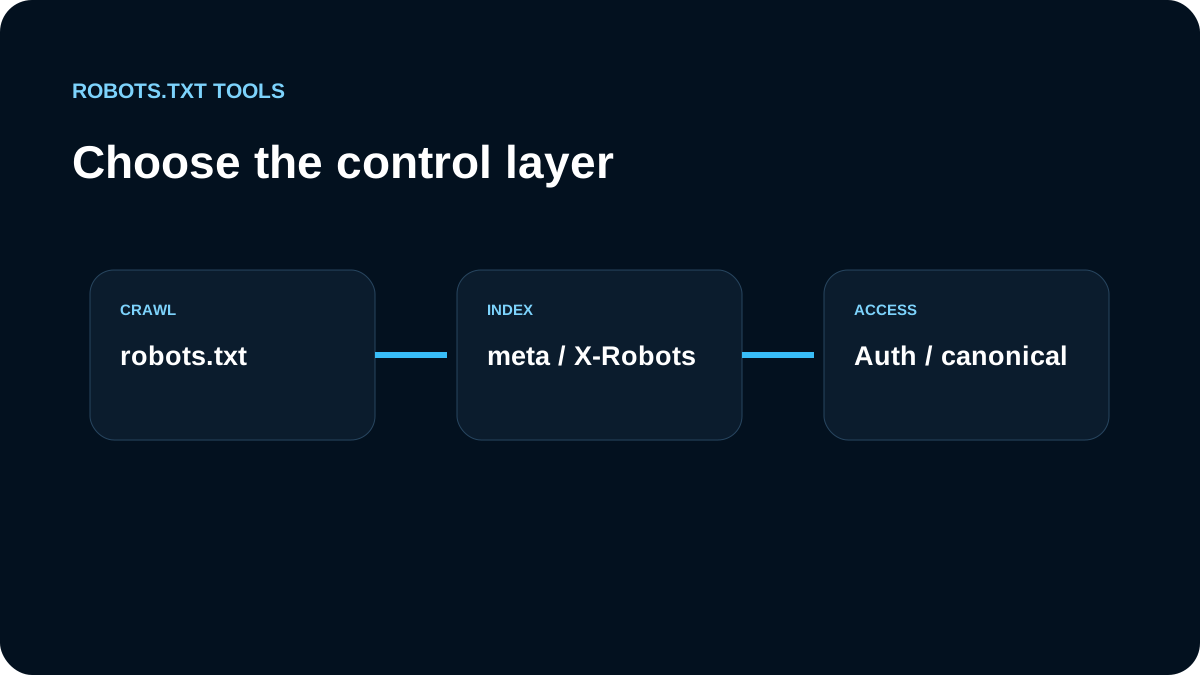
Noi scegliamo il livello in base all’obiettivo: robots.txt per il crawling, noindex per l’indicizzazione, canonical per i duplicati, redirect per gli spostamenti e autenticazione per il privato.
Robots.txt risponde a un problema di crawl
Disallow non è un comando affidabile per rimuovere una URL dall’indice.
Meta robots deve essere leggibile
<meta name="robots" content="noindex">
Se robots.txt blocca la stessa pagina, il crawler può non leggere noindex.
X-Robots-Tag opera negli header HTTP
X-Robots-Tag: noindex
È utile anche per PDF e risorse non HTML.
Canonical non è sicurezza
canonical consolida segnali. Per informazioni private usiamo autenticazione o authorization reale.
La nostra sequenza di scelta
Privato → autenticazione. Pubblico fuori indice → noindex/X-Robots-Tag. Duplicato → canonical/redirect. Crawl waste → valutare robots.txt. Infine controlliamo la production con il checker.
Ogni controllo risolve un problema diverso
Disallow controlla il crawling; noindex chiede l’esclusione dai risultati quando il crawler può leggere la pagina; X-Robots-Tag è utile per PDF e risorse non HTML; canonical consolida duplicati; autenticazione protegge contenuti privati. Non li trattiamo come livelli intercambiabili da accumulare “per sicurezza”.
Bloccare una pagina in robots.txt e aggiungere anche noindex può impedire al crawler di leggere proprio la direttiva di indicizzazione. Per un URL pubblico che deve uscire dai risultati lasciamo il crawl e usiamo noindex. Per contenuti riservati usiamo access control reale.
Partiamo dal sintomo
Chiediamo se il problema è crawl waste, presenza nei risultati, duplicazione, migrazione o privacy. Poi scegliamo un controllo principale e aggiungiamo altri segnali solo quando sappiamo spiegare l’interazione, verificando robots.txt, HTML/header e risposta finale in produzione.