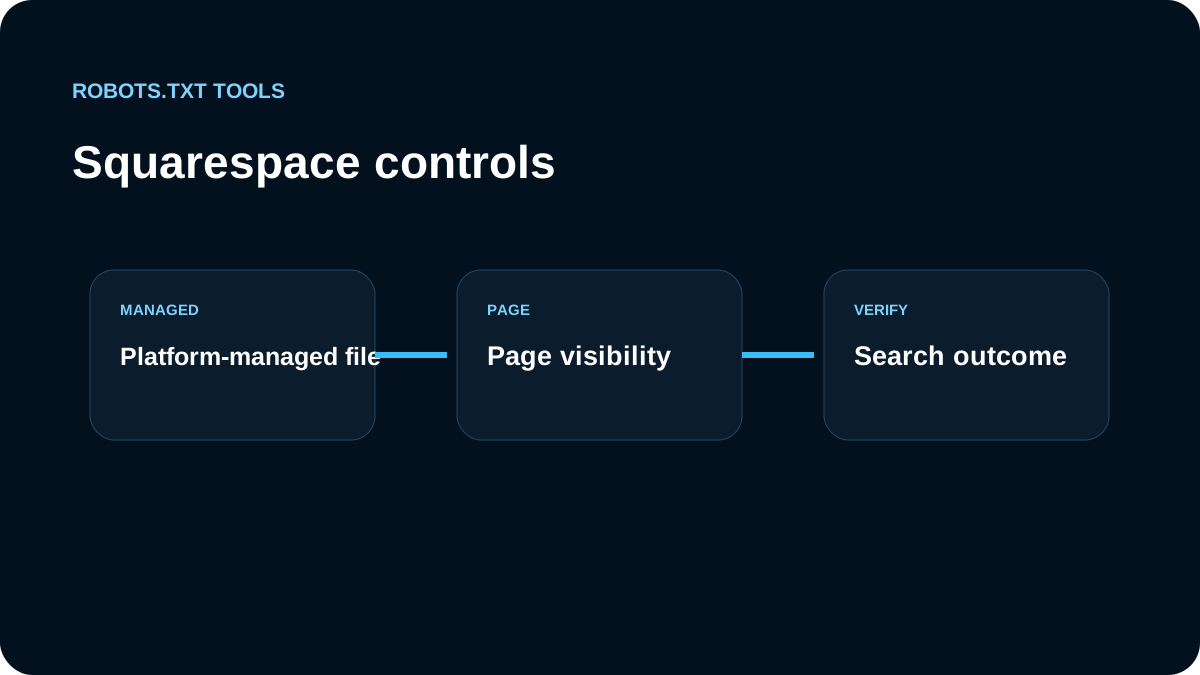
Squarespace mengelola sebagian besar robots.txt. Kami memakai kontrol resmi platform, bukan workflow raw file yang tidak tersedia.
Kami mengenali aturan /search
Disallow untuk /search dapat menjadi perilaku normal platform.
Crawlers mengatur visibilitas luas
Untuk keputusan tingkat situs, kami memakai Crawlers lalu memeriksa output publik.
noindex lebih tepat untuk satu halaman
URL publik individual memakai pengaturan noindex/indexing; konten privat memakai password atau access control.
Sitemap dibuat otomatis
Kami membuka sitemap yang generated dan memeriksa URL canonical, bukan mencoba mengelola XML secara manual.
Kami memeriksa hasil live
Kami meninjau /robots.txt, /sitemap.xml, checker, dan tester.