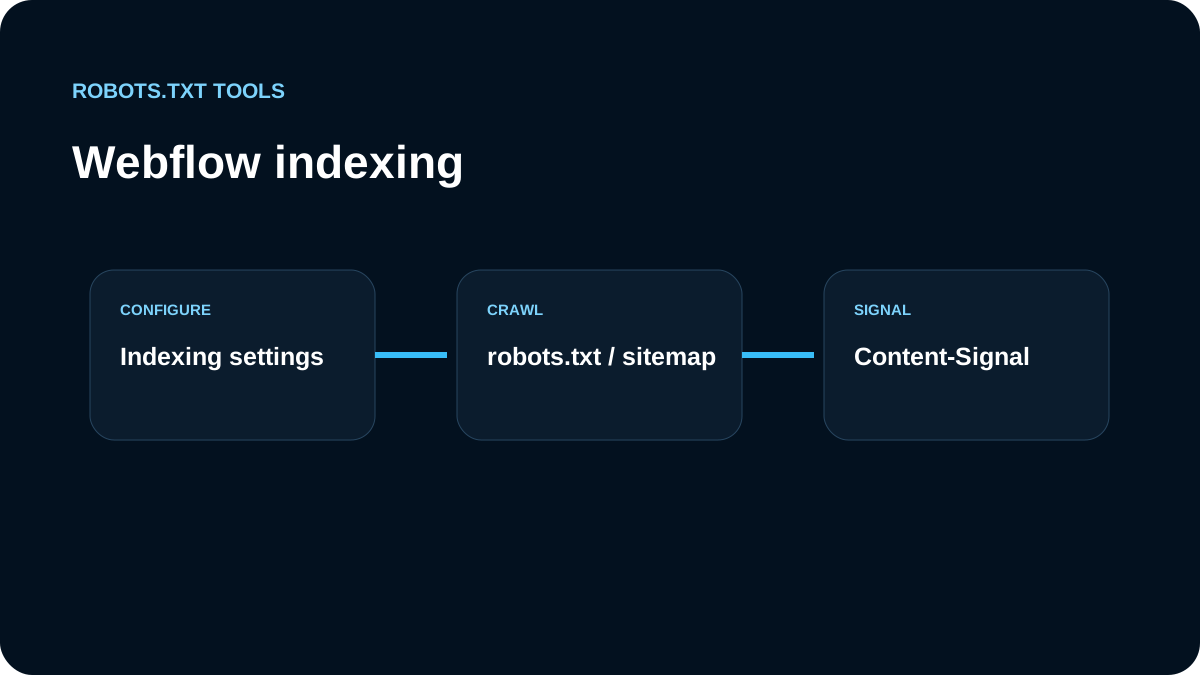
In Webflow behandeln wir robots.txt als Teil des Publish-Prozesses. Die Einstellungen liegen unter Site settings → SEO → Indexing.
Wir prüfen Production zuerst
Wir öffnen /robots.txt und suchen nach zu breiten Regeln, falschem Host und doppelten Sitemap:-Zeilen.
Wir berücksichtigen die automatische Sitemap
Bevor wir eine Zeile hinzufügen, prüfen wir, ob Webflow sie bereits erzeugt. Bei Reverse-Proxy- oder Multi-Site-Setups beachten wir die dokumentierte Möglichkeit, die automatische Referenz zu ersetzen.
Speichern ist nicht Publish
Wir ändern, speichern, veröffentlichen und rufen die Datei erneut ab. Bleibt sie alt, untersuchen wir Cache und Domain-Routing.
Content-Signal ist eine andere Ebene
Content-Signal beschreibt Präferenzen zur KI-Inhaltsnutzung; robots.txt steuert Crawling. Diese Mechanismen halten wir getrennt.
Wir testen vor dem Release
Wir nutzen Tester und Validator. Private Previews bekommen echten Zugriffsschutz.