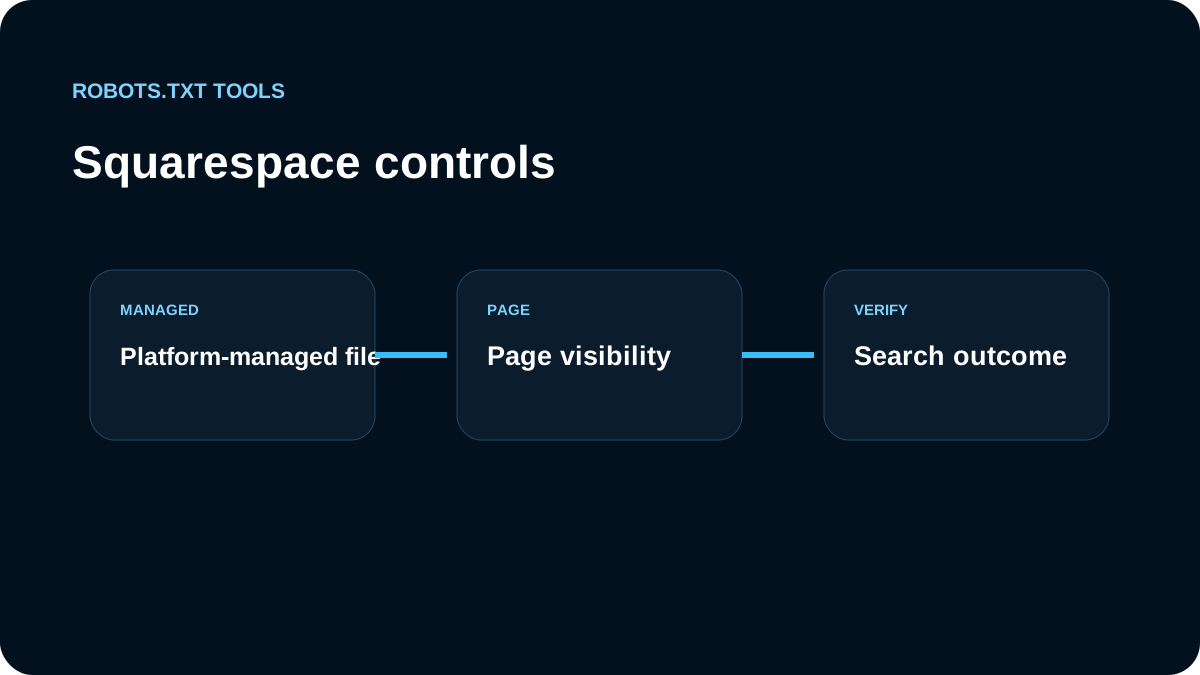
Squarespace gestisce gran parte di robots.txt. Noi usiamo i controlli supportati invece di presumere accesso libero al file raw.
Riconosciamo il comportamento di /search
Un Disallow su /search può essere un default normale della piattaforma.
Crawlers gestisce la visibilità generale
Per decisioni a livello sito usiamo Crawlers e verifichiamo l’output pubblicato.
noindex è più preciso per una pagina
Una singola URL pubblica usa il controllo noindex/indicizzazione; il privato rimane dietro password o access control.
La sitemap è automatica
Apriamo la sitemap generata e controlliamo gli URL canonical invece di trattarla come XML manuale.